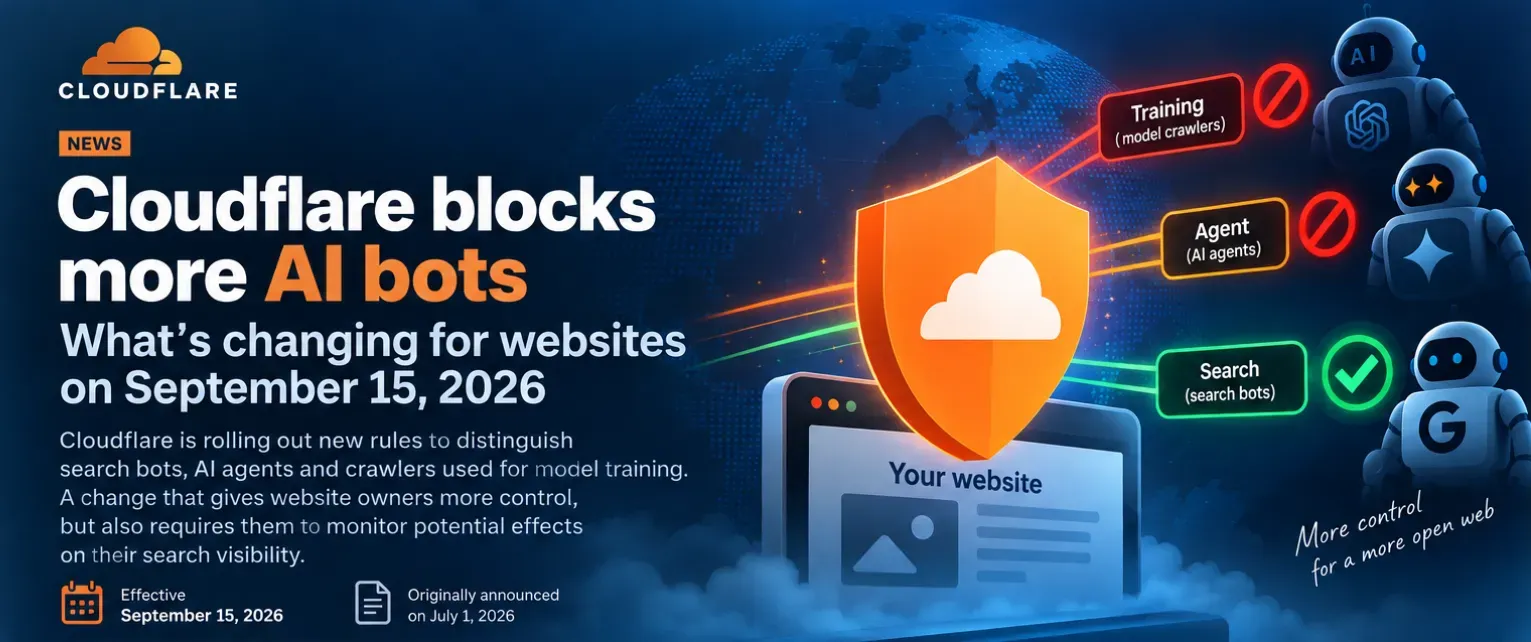
Cloudflare está cambiando la forma de gestionar los bots relacionados con la inteligencia artificial. A partir del 15 de septiembre de 2026, nuevas reglas distinguen entre los rastreadores de búsqueda, los agentes de IA y los rastreadores de entrenamiento, con posibles consecuencias para la protección de los contenidos y el posicionamiento en buscadores.
A partir del 15 de septiembre de 2026, Cloudflare aplica nuevas reglas para distinguir mejor entre los robots de búsqueda, los agentes de IA y los crawlers utilizados para entrenar modelos. Estos ajustes ofrecen un mayor control a los propietarios de sitios, pero requieren verificar sus efectos sobre el rastreo y el posicionamiento orgánico.
En resumen
Reglas adaptadas al uso de los robots
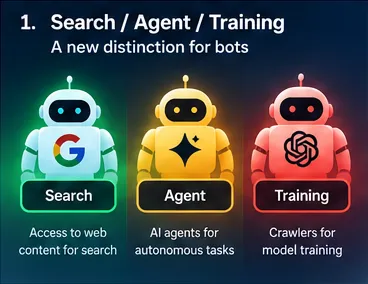
Cloudflare distingue ahora tres categorías principales: Search, Agent y Training. La atención se centra sobre todo en los crawlers multiuso, a los que una política restrictiva puede impedir también un acceso necesario para la búsqueda.
La llegada de las inteligencias artificiales generativas ha modificado profundamente el papel de los robots que recorren la Web. Durante mucho tiempo, el funcionamiento era relativamente sencillo: un motor de búsqueda exploraba una página, la indexaba y luego podía dirigir a los internautas al sitio correspondiente.
Hoy los usos son más variados. Algunos robots siguen alimentando los motores de búsqueda. Otros recopilan datos destinados al entrenamiento de modelos de inteligencia artificial. Otros intervienen en tiempo real en nombre de un usuario o de un agente de IA.
Cloudflare evoluciona sus herramientas para diferenciar los robots según el uso que hacen de los contenidos.
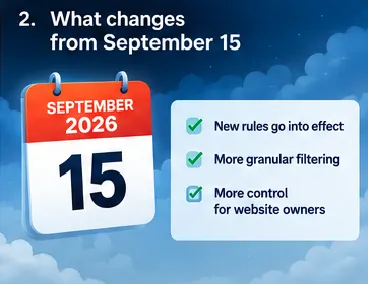
Cloudflare había anunciado el 1er de julio de 2026 una evolución de sus herramientas de gestión de este tráfico automatizado. Los nuevos ajustes entran en vigor el 15 de septiembre de 2026. Detrás de esta configuración técnica se plantea una cuestión importante: ¿cómo limitar determinados usos del propio contenido sin bloquear involuntariamente los robots útiles para su visibilidad?
Tres categorías para distinguir los robots de IA
Cloudflare ya no intenta únicamente separar los robots «buenos» de los «malos». La plataforma clasifica en mayor medida el tráfico automatizado según el uso que se hace del contenido.
Search
Explorar para responder a búsquedas
Esta categoría corresponde a los robots que recorren e indexan los contenidos para responder posteriormente a búsquedas. Autorizar su acceso puede permitir que las páginas sean descubiertas, indexadas y propuestas a los internautas.
Agent
Actuar en tiempo real para un usuario
Estos robots intervienen en nombre de un usuario. Por ejemplo, un asistente de IA puede consultar una página o recuperar información durante una tarea, sin necesariamente crear un índice permanente.
Training
Entrenar o ajustar un modelo
Esta categoría designa los crawlers que utilizan los contenidos para entrenar o ajustar modelos de inteligencia artificial. Para el sitio de origen, este acceso no genera necesariamente una visita directa.
Objetivo
Aplicar políticas diferenciadas
La nueva clasificación permite a los propietarios de sitios diferenciar las reglas según el uso: búsqueda, intervención puntual de un agente o entrenamiento de un modelo.
Qué cambia el 15 de septiembre de 2026
El cambio principal afecta a los nuevos dominios añadidos a la red de Cloudflare a partir del 15 de septiembre. De forma predeterminada, los robots clasificados como Training o Agent quedarán bloqueados en las páginas donde Cloudflare detecte publicidad. Los robots pertenecientes únicamente a la categoría Search seguirán autorizados de forma predeterminada.
Cloudflare relaciona esta elección con la lógica económica de las páginas financiadas por publicidad. Su modelo suele basarse en la consulta por parte de un internauta. Un crawler que recupera únicamente contenido para entrenar un modelo no genera esa atención humana. En cambio, un motor de búsqueda puede contribuir a descubrir la página y atraerle una visita.
Las políticas de Cloudflare pueden ajustarse según la categoría del robot y el tipo de página correspondiente.
El caso más complejo de los robots multiuso
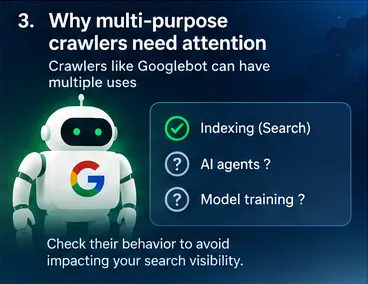
Un mismo crawler puede participar en varias actividades. Puede alimentar un servicio de búsqueda y utilizarse también en un contexto relacionado con la inteligencia artificial o el entrenamiento. Cloudflare cita especialmente Googlebot, Applebot y BingBot entre los ejemplos afectados por esta problemática.
A partir del 15 de septiembre, cuando un robot pertenezca a varias clasificaciones, Cloudflare aplicará la política más restrictiva compatible con las decisiones del propietario del sitio. Por tanto, un crawler que combine una función de búsqueda y una función de entrenamiento podrá bloquearse si el administrador ha elegido bloquear los usos clasificados como Training.
Este cambio también afecta al antiguo ajuste «Block AI bots», que evoluciona hacia políticas más detalladas.
Un robot multiuso puede quedar sujeto a la regla más restrictiva, incluso cuando participa en el rastreo destinado a la búsqueda.
Punto de atención
Una regla dirigida a la IA puede tener un efecto más amplio
Con un robot multiuso, bloquear una clasificación relacionada con el entrenamiento también puede impedir una actividad de búsqueda realizada por el mismo crawler. Por tanto, hay que verificar el alcance exacto de la regla antes de activarla.
Por qué puede convertirse en un asunto de posicionamiento
Bloquear los crawlers utilizados exclusivamente para entrenar un modelo de IA puede encajar con la estrategia de un sitio. En cambio, bloquear por error un robot que participa en la indexación puede afectar a su visibilidad.
Google indica que Googlebot es su robot de rastreo, utilizado para descubrir y recorrer las páginas accesibles para su motor. Su acceso forma parte de las condiciones técnicas que permiten que una página pueda ser elegible para la indexación.
Activar una opción para bloquear los robots de IA no hará desaparecer automáticamente un sitio de los resultados de búsqueda: las consecuencias dependen de la configuración y de los robots afectados.
Bloquear el entrenamiento de IA ya no es una decisión binaria
La cuestión ya no se reduce a autorizar o bloquear todos los robots de IA. Un propietario de sitio puede querer:
autorizar los motores de búsqueda;
rechazar el uso de sus contenidos para entrenar determinados modelos;
permitir que un asistente de IA acceda puntualmente a una página a petición de un usuario;
bloquear crawlers desconocidos o especialmente agresivos;
aplicar reglas diferentes a los contenidos públicos y a las áreas sensibles.
La búsqueda, la acción en tiempo real y el entrenamiento no tienen el mismo valor para el editor ni los mismos riesgos.
Por tanto, no todos los accesos automatizados tienen el mismo valor ni el mismo nivel de riesgo. Esta distinción cobra aún más importancia a medida que los agentes de IA pueden navegar por sitios, rellenar formularios, consultar aplicaciones o actuar directamente sobre interfaces.
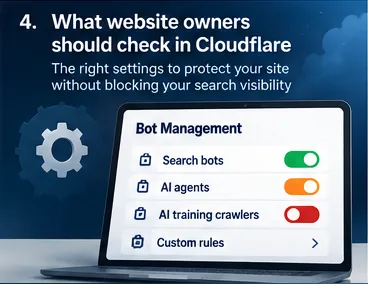
Qué verificar si el sitio utiliza Cloudflare
No es necesario bloquear todos los robots por precaución. Un enfoque más adecuado consiste en examinar la configuración existente y definir con precisión los usos que se desean autorizar.
01
Comprobar la política activa
Un sitio configurado hace varios años puede conservar un ajuste antiguo, mientras que un dominio nuevo puede beneficiarse de parámetros predeterminados diferentes. Hay que examinar la configuración que se aplica realmente a cada zona.
02
Identificar los robots indispensables
Cuando los motores de búsqueda representan un canal de adquisición importante, sus robots deben supervisarse. Search Console permite, en particular, realizar un seguimiento del rastreo y la indexación en Google.
03
Observar los registros después de modificar la configuración
Después de activar una regla, conviene supervisar las solicitudes bloqueadas, los posibles errores y la evolución del rastreo para detectar efectos no deseados.
04
Tener en cuenta el modelo económico
Un medio financiado por publicidad, un sitio corporativo, una documentación técnica y una aplicación SaaS no tienen las mismas prioridades. La configuración debe responder a los objetivos específicos del sitio.
05
Probar el acceso a las páginas importantes
La herramienta de inspección de URL de Google puede ayudar a verificar si una página sigue siendo accesible. Esta comprobación complementa el análisis de los registros y el seguimiento de los informes de rastreo después de un cambio de política.
Antes y después del 15 de septiembre, deben comprobarse la configuración activa, los registros de Cloudflare y las herramientas de inspección de los motores.
Hacia una Web en la que cada robot deberá anunciar su intención
La evolución propuesta por Cloudflare ilustra un cambio más amplio de la Web. La cuestión ya no consiste progresivamente solo en saber quién accede a una página, sino por qué.
La búsqueda, el entrenamiento de un modelo, una respuesta generada por una IA, un agente autónomo o la navegación humana no crean la misma relación entre un sitio y el servicio que utiliza su contenido. Por ello, las soluciones técnicas empiezan a integrar esta distinción en sus herramientas de seguridad y gestión del tráfico.
Esta granularidad ofrece un mayor control a los editores, pero también les confiere una nueva responsabilidad: comprender los efectos de una regla antes de aplicarla.
Lo que hay que recordar
Cloudflare distingue las categorías Search, Agent y Training.
Para los nuevos dominios, Agent y Training se bloquean de forma predeterminada en las páginas que contienen publicidad.
Los robots pertenecientes únicamente a Search siguen autorizados de forma predeterminada.
Un crawler multiuso puede quedar sujeto a la política más restrictiva elegida por el propietario del sitio.
Cada modificación debe supervisarse para identificar sus efectos sobre el rastreo y la indexación.
La estrategia debe definir los usos aceptables del contenido, en lugar de tratar todos los robots de IA de la misma manera.
Fuentes y método Mostrar las referencias
Esta noticia se ha preparado a partir del anuncio oficial publicado por Cloudflare el 1er de julio de 2026, de la documentación de Cloudflare relativa a las políticas de gestión de robots de IA y de la documentación de Google Search Central dedicada a Googlebot.
Cloudflare — Tu sitio, tus reglas: nuevas opciones de gestión del tráfico relacionado con la IA para todos los clientes
Cloudflare Developers — Block AI Bots
Google Search Central — Presentación de Googlebot
Google Search Central — Requisitos técnicos de Google Search
WEB Y CIBERSEGURIDAD
Una base web fiable se prepara antes de que ocurra un incidente.
La auditoría del código, las dependencias y las rutas sensibles convierte una alerta técnica en un plan de acción controlado.