Cloudflare fait évoluer la gestion des robots liés à l’intelligence artificielle. À partir du 15 septembre 2026, de nouvelles règles distinguent les robots de recherche, les agents IA et les crawlers d’entraînement, avec des conséquences possibles sur la protection des contenus et le référencement.
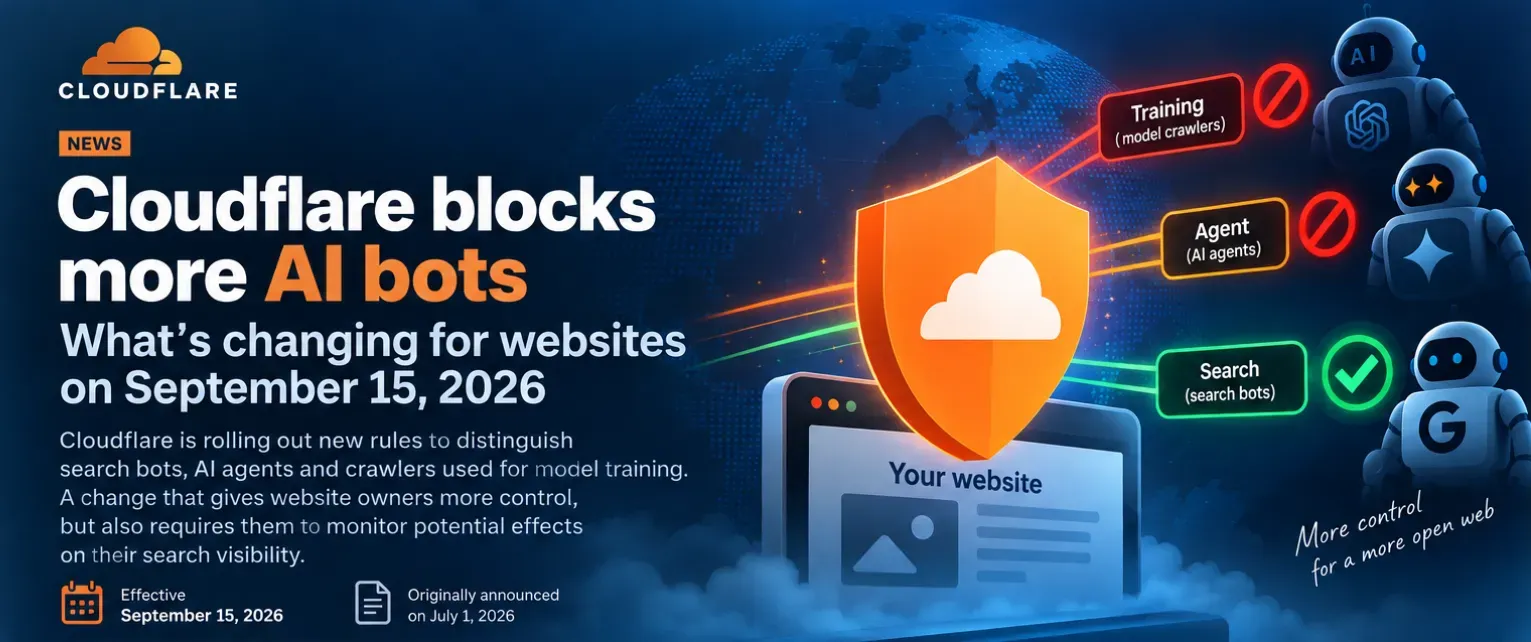
À compter du 15 septembre 2026, Cloudflare applique de nouvelles règles pour mieux distinguer les robots de recherche, les agents IA et les crawlers utilisés pour entraîner des modèles. Ces paramètres donnent davantage de contrôle aux propriétaires de sites, mais nécessitent d’en vérifier les effets sur l’exploration et le référencement naturel.
En bref
Des règles adaptées à l’usage des robots
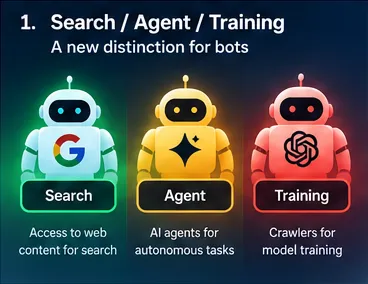
Cloudflare distingue désormais trois catégories principales : Search, Agent et Training. La vigilance porte surtout sur les crawlers multi-usages, auxquels une politique restrictive peut interdire un accès également nécessaire à la recherche.
L’arrivée des intelligences artificielles génératives a profondément modifié le rôle des robots qui parcourent le Web. Pendant longtemps, le fonctionnement était relativement simple : un moteur de recherche explorait une page, l’indexait, puis pouvait orienter des internautes vers le site concerné.
Les usages sont aujourd’hui plus variés. Certains robots continuent d’alimenter les moteurs de recherche. D’autres collectent des données destinées à l’entraînement de modèles d’intelligence artificielle. D’autres encore interviennent en temps réel pour le compte d’un utilisateur ou d’un agent IA.
Cloudflare fait évoluer ses outils afin de différencier les robots selon l’usage qu’ils font des contenus.
Cloudflare avait annoncé le 1er juillet 2026 une évolution de ses outils de gestion de ce trafic automatisé. Les nouveaux paramètres entrent en application le 15 septembre 2026. Derrière ce réglage technique se pose une question importante : comment limiter certains usages de son contenu sans bloquer involontairement les robots utiles à sa visibilité ?
Trois catégories pour distinguer les robots IA
Cloudflare ne cherche plus seulement à séparer les « bons » et les « mauvais » robots. La plateforme classe davantage le trafic automatisé selon l’utilisation qui est faite du contenu.
Search
Explorer pour répondre à des recherches
Cette catégorie correspond aux robots qui parcourent et indexent les contenus afin de répondre ensuite à des recherches. Autoriser leur accès peut permettre aux pages d’être découvertes, indexées et proposées aux internautes.
Agent
Agir en temps réel pour un utilisateur
Ces robots interviennent au nom d’un utilisateur. Un assistant IA peut, par exemple, consulter une page ou récupérer une information au cours d’une tâche, sans nécessairement constituer un index permanent.
Training
Entraîner ou affiner un modèle
Cette catégorie désigne les crawlers qui utilisent les contenus pour entraîner ou affiner des modèles d’intelligence artificielle. Pour le site d’origine, cet accès ne produit pas nécessairement de visite directe.
Objectif
Appliquer des politiques distinctes
La nouvelle classification permet aux propriétaires de sites de différencier les règles selon l’usage : recherche, intervention ponctuelle d’un agent ou entraînement d’un modèle.
Ce qui change le 15 septembre 2026
Le changement principal concerne les nouveaux domaines ajoutés au réseau Cloudflare à partir du 15 septembre. Par défaut, les robots classés Training ou Agent seront bloqués sur les pages où Cloudflare détecte de la publicité. Les robots relevant uniquement de la catégorie Search resteront autorisés par défaut.
Cloudflare relie ce choix à la logique économique des pages financées par la publicité. Leur modèle repose généralement sur la consultation par un internaute. Un crawler récupérant uniquement du contenu pour entraîner un modèle ne génère pas cette attention humaine. Un moteur de recherche peut, à l’inverse, contribuer à faire découvrir la page et à lui apporter une visite.
Les politiques Cloudflare peuvent être ajustées selon la catégorie du robot et le type de page concerné.
Le cas plus complexe des robots multi-usages
Un même crawler peut participer à plusieurs activités. Il peut alimenter un service de recherche tout en étant également utilisé dans un contexte lié à l’intelligence artificielle ou à l’entraînement. Cloudflare cite notamment Googlebot, Applebot et BingBot parmi les exemples concernés par cette problématique.
À partir du 15 septembre, lorsqu’un robot relève de plusieurs classifications, Cloudflare applique la politique la plus restrictive compatible avec les choix du propriétaire du site. Un crawler combinant une fonction de recherche et une fonction d’entraînement pourra donc être bloqué si l’administrateur a choisi de bloquer les usages classés Training.
Ce changement concerne également l’ancien réglage « Block AI bots », qui évolue au profit de politiques plus détaillées.
Un robot multi-usage peut être soumis à la règle la plus restrictive, y compris lorsqu’il participe à l’exploration destinée à la recherche.
Point de vigilance
Une règle visant l’IA peut avoir un effet plus large
Avec un robot multi-usage, bloquer une classification liée à l’entraînement peut également empêcher une activité de recherche portée par le même crawler. La portée exacte de la règle doit donc être vérifiée avant son activation.
Pourquoi cela peut devenir un sujet de référencement
Bloquer les crawlers utilisés exclusivement pour entraîner un modèle d’IA peut correspondre à la stratégie d’un site. Bloquer par erreur un robot participant à l’indexation peut, en revanche, affecter sa visibilité.
Google indique que Googlebot est son robot d’exploration utilisé pour découvrir et parcourir les pages accessibles à son moteur. Son accès fait partie des conditions techniques permettant à une page d’être éligible à l’indexation.
Activer une option de blocage des robots IA ne fera pas automatiquement disparaître un site des résultats de recherche : les conséquences dépendent de la configuration et des robots effectivement concernés.
Bloquer l’entraînement IA n’est plus une décision binaire
La question ne se résume plus à autoriser ou bloquer tous les robots IA. Un propriétaire de site peut vouloir :
autoriser les moteurs de recherche ;
refuser l’utilisation de ses contenus pour entraîner certains modèles ;
permettre à un assistant IA d’accéder ponctuellement à une page à la demande d’un utilisateur ;
bloquer des crawlers inconnus ou particulièrement agressifs ;
appliquer des règles différentes aux contenus publics et aux espaces sensibles.
Recherche, action en temps réel et entraînement ne présentent ni la même valeur pour l’éditeur, ni les mêmes risques.
Tous les accès automatisés n’ont donc pas la même valeur ni le même niveau de risque. Cette distinction devient encore plus importante à mesure que les agents IA peuvent naviguer sur des sites, remplir des formulaires, interroger des applications ou agir directement sur des interfaces.
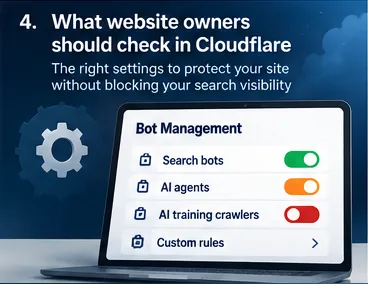
Que vérifier si son site utilise Cloudflare ?
Il n’est pas nécessaire de bloquer tous les robots par précaution. Une démarche plus adaptée consiste à examiner la configuration existante et à définir précisément les usages à autoriser.
01
Contrôler la politique active
Un site configuré depuis plusieurs années peut conserver un ancien réglage, tandis qu’un nouveau domaine bénéficie de paramètres par défaut différents. Il faut examiner la configuration réellement appliquée à chaque zone.
02
Identifier les robots indispensables
Lorsque les moteurs de recherche représentent un canal d’acquisition important, leurs robots doivent être surveillés. Search Console permet notamment de suivre l’exploration et l’indexation dans Google.
03
Observer les journaux après modification
Après l’activation d’une règle, il convient de surveiller les requêtes bloquées, les erreurs éventuelles et l’évolution de l’exploration afin de détecter les effets indésirables.
04
Tenir compte du modèle économique
Un média financé par la publicité, un site vitrine, une documentation technique et une application SaaS n’ont pas les mêmes priorités. La configuration doit répondre aux objectifs propres au site.
05
Tester l’accès aux pages importantes
L’outil d’inspection d’URL de Google peut aider à vérifier si une page demeure accessible. Cette vérification complète l’analyse des journaux et le suivi des rapports d’exploration après un changement de politique.
Avant et après le 15 septembre, la configuration active, les journaux Cloudflare et les outils d’inspection des moteurs doivent être contrôlés.
Vers un Web où chaque robot devra annoncer son intention
L’évolution proposée par Cloudflare illustre un changement plus large du Web. La question n’est progressivement plus seulement de savoir qui accède à une page, mais pourquoi.
Recherche, entraînement d’un modèle, réponse générée par une IA, agent autonome ou navigation humaine ne créent pas la même relation entre un site et le service qui utilise son contenu. Les solutions techniques commencent donc à intégrer cette distinction dans leurs outils de sécurité et de gestion du trafic.
Cette granularité donne davantage de contrôle aux éditeurs, mais leur confère également une responsabilité nouvelle : comprendre les effets d’une règle avant de l’appliquer.
Ce qu’il faut retenir
Cloudflare distingue les catégories Search, Agent et Training.
Pour les nouveaux domaines, Agent et Training sont bloqués par défaut sur les pages comportant de la publicité.
Les robots relevant uniquement de Search restent autorisés par défaut.
Un crawler multi-usage peut être soumis à la politique la plus restrictive choisie par le propriétaire du site.
Chaque modification doit être suivie afin d’identifier ses effets sur l’exploration et l’indexation.
La stratégie doit définir les usages acceptables du contenu plutôt que traiter tous les robots IA de la même manière.
Sources et méthode Afficher les références
Cette actualité a été préparée à partir de l’annonce officielle publiée par Cloudflare le 1er juillet 2026, de la documentation Cloudflare relative aux politiques de gestion des robots IA et de la documentation Google Search Central consacrée à Googlebot.
Cloudflare — Votre site, vos règles : nouvelles options de gestion du trafic lié à l’IA pour tous les clients
Cloudflare Developers — Block AI Bots
Google Search Central — Présentation de Googlebot
Google Search Central — Exigences techniques de Google Search
WEB & CYBERSÉCURITÉ
Un socle web fiable se prépare avant l’incident.
Audit du code, dépendances, parcours sensibles et stratégie de mise à jour : transformez une alerte technique en plan d’action maîtrisé.
Priorités et risques clairement identifiés
Correctifs testés avec possibilité de retour arrière