Elegir los conocimientos
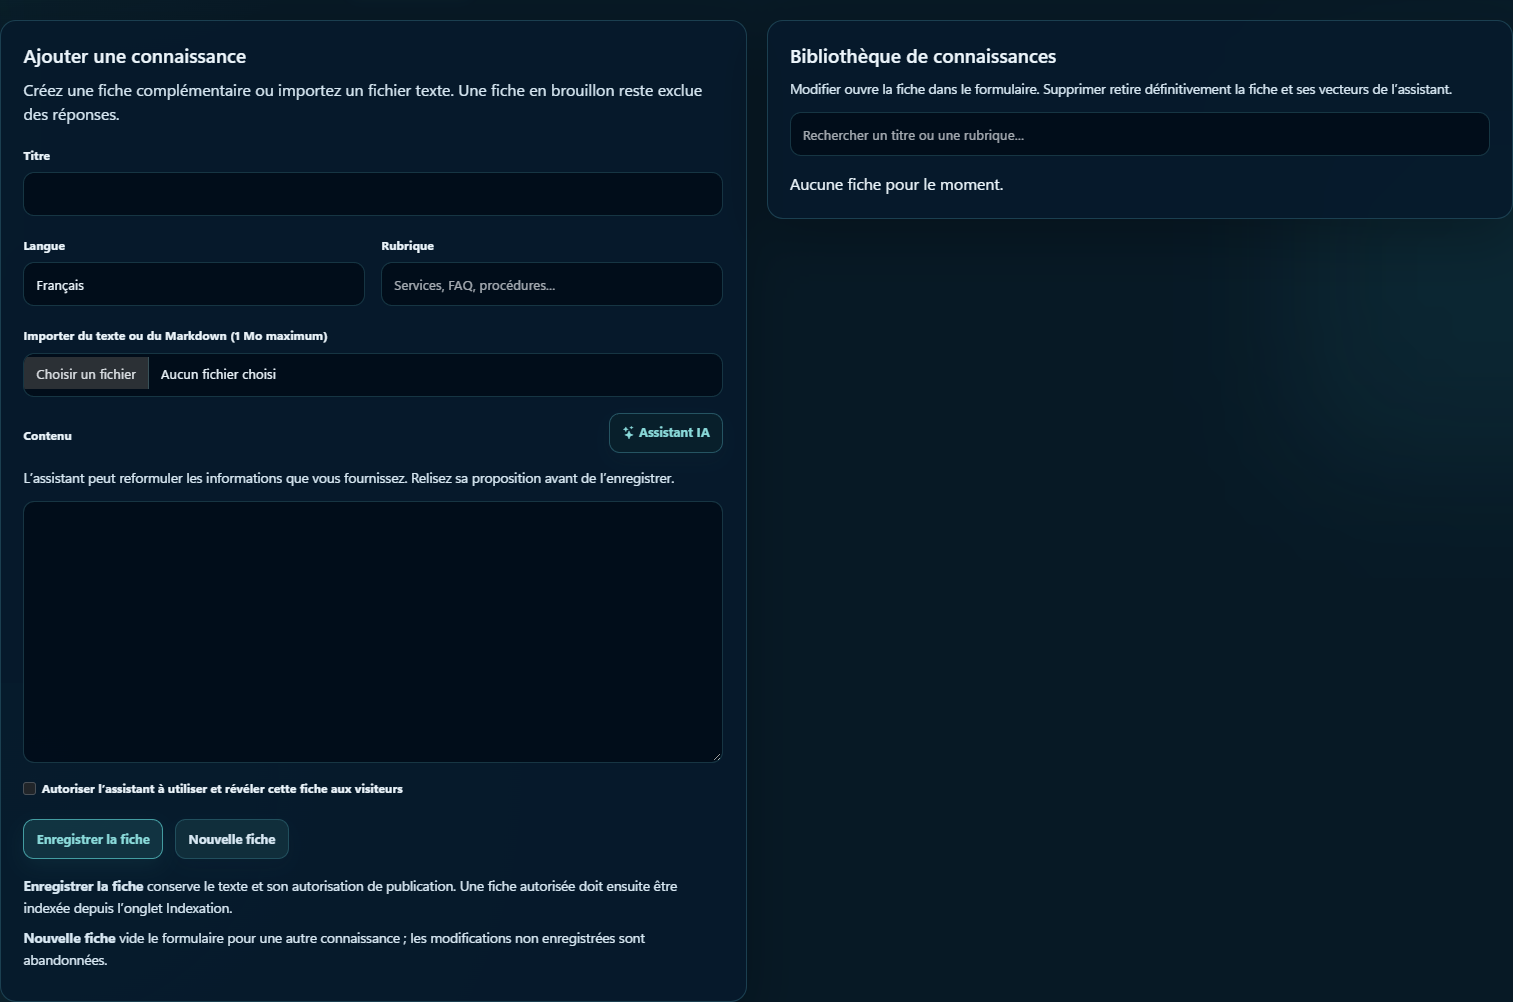
Selección de contenidos, información complementaria y preparación del índice documental.
Asistente IA RAG · SDX
Una burbuja de chat integrada en el CMS: intercambios sencillos resueltos localmente, búsqueda documental cuando hace falta y respuestas generadas en la GPU del visitante.
Todos los proyectos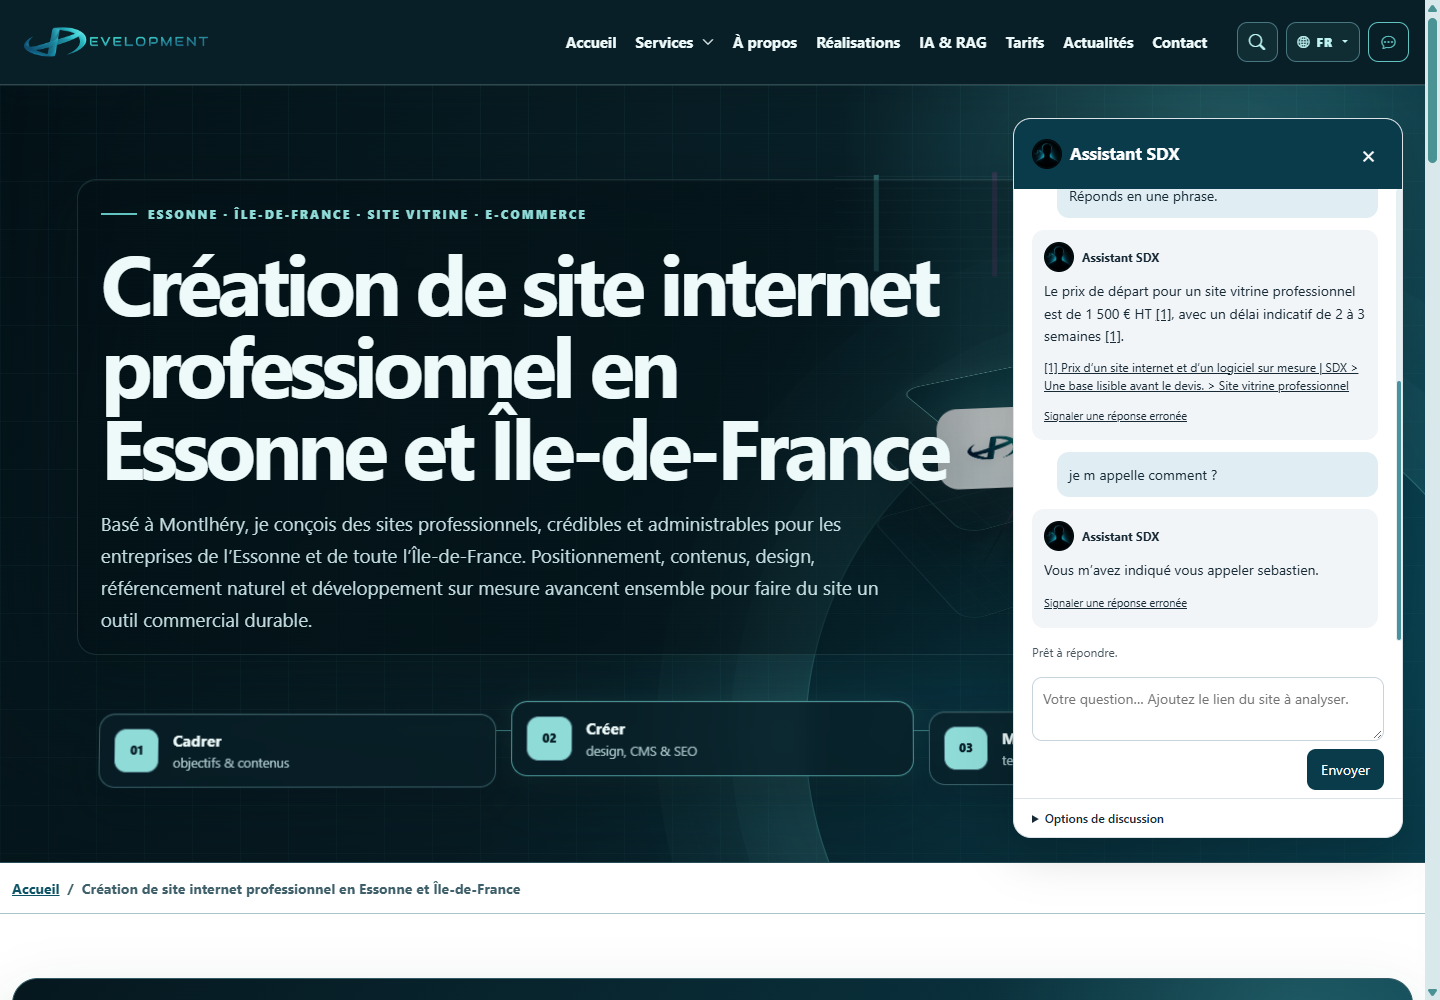 Ampliar captura
01 / RAG
Las páginas de una web explican una oferta, sus precios y su funcionamiento. Sin embargo, el visitante no siempre sabe dónde buscar. El objetivo era permitirle preguntar y obtener una respuesta relacionada con la información publicada.
He desarrollado esta aplicación en la propia web de SDX Development. Es un proyecto interno, disponible en producción, que combina búsqueda documental, modelos locales, administración de conocimientos e interfaz de conversación.
ACTUALIZACIÓN · 3 DE OCTUBRE DE 2026
Los saludos, agradecimientos e intercambios sobre el nombre siguen ahora un recorrido local, sin cargar el modelo ni buscar documentos. Una presentación permite recoger el nombre; preguntarlo después recuerda esa declaración en lugar de interpretar la pregunta como un nombre nuevo.
El RAG interviene cuando hacen falta conocimientos. Las preguntas de seguimiento sobre precio o plazo retoman el proyecto descrito explícitamente por el visitante. Las fichas de oferta que contienen el importe o la duración solicitados se priorizan para reducir confusiones con otro servicio.
Una petición como «resume esta página» tiene en cuenta la página pública abierta, su título y su dirección. La lectura pasa por el servidor y sus protecciones de URL; un enlace indicado explícitamente por el visitante tiene prioridad. El contenido de la página no se convierte en instrucciones para el modelo.
El nombre puede conservarse en un perfil local opcional, separado del historial de conversación. Tras navegar o después de dos minutos de inactividad con el chat cerrado, aparece una invitación junto a la burbuja que puede usar ese nombre. No abre automáticamente la ventana de conversación.
Las primeras pruebas del 3 de octubre verificaron presentación, recuerdo del nombre, resumen de página, precios y plazos en Chrome Windows. Una prueba posterior utilizó el Galaxy S25 Ultra realmente conectado y el ordenador: Medidas detalla los tiempos totales, tokens/s y defectos observados con los modelos guardados.
El pequeño modelo móvil sigue siendo una limitación del proyecto. Todavía puede rechazar una respuesta de precio pese a disponer de la fuente correcta. Los controles adicionales bloquean algunas omisiones de precio, importes de otra oferta y comentarios internos, pero el verificador semántico puede aceptar errores. Se comparó Qwen3-0.6B sin sustituir el modelo en producción: con los prompts probados, su verificador aceptaba cuatro borradores incorrectos de seis.
02 / RAG
Los intercambios sencillos empiezan sin búsqueda. Cuando la pregunta necesita información de la web o de sus servicios, el RAG vincula la respuesta con fuentes y reparte el trabajo entre navegador y servidor.
El CMS prepara un índice a partir de los contenidos seleccionados y de información añadida por el administrador.
El navegador calcula una representación de la pregunta. El servidor busca los fragmentos pertinentes en el índice y devuelve sus fuentes.
Un modelo ejecutado en el navegador redacta la respuesta utilizando los fragmentos encontrados. Una búsqueda adicional puede enriquecer el contexto.
Un control local revisa el borrador antes de mostrarlo. Si los intentos limitados no producen una respuesta admisible, el asistente explica el límite y puede proponer contactar.
La generación se ejecuta en el dispositivo del visitante con acceso a la GPU. El servicio no funciona completamente sin conexión: descarga modelos y consulta el servidor para recuperar fuentes. Las preguntas sin respuesta pueden conservarse para ampliar los conocimientos.
El servidor conserva los conocimientos y recupera los fragmentos. El navegador ejecuta la reformulación, los embeddings, la redacción y la revisión. La memoria local y opcional es un tercer recurso: ayuda a seguir la solicitud sin sustituir las fuentes documentales.
La petición actual, el proyecto descrito explícitamente, los últimos intercambios y una posible referencia pública. Los saludos e intercambios sencillos sobre el nombre pueden resolverse localmente antes de este recorrido RAG.
El modelo transforma la solicitud en una consulta documental autónoma. La pregunta original se conserva junto con la reformulación.
Las consultas se convierten en vectores calculados con WebGPU y enviados a la API del sitio.
El índice selecciona fragmentos del idioma adecuado, aplica el umbral de similitud y combina los resultados. Devuelve textos, títulos y enlaces.
Si el visitante lo autoriza, IndexedDB recupera una pregunta anterior relacionada. Complementa los intercambios recientes sin convertir su antigua respuesta en prueba.
El modelo utiliza las instrucciones del CMS, la pregunta, el contexto de conversación y los fragmentos recuperados. El borrador aún no se muestra.
El mismo modelo contrasta el borrador con las fuentes. Si se rechaza: como máximo una nueva búsqueda y una segunda redacción.
El borrador aceptado se muestra con las fuentes. Si faltan datos suficientes, se ofrece contacto humano. Un intercambio admisible puede guardarse localmente.
Antes de las preguntas, el administrador prepara los contenidos y calcula sus embeddings en el navegador. Los vectores documentales se guardan en el servidor; cada visitante calcula los vectores de sus preguntas sin reindexar las páginas del sitio.
EJECUCIÓN
WebGPU permite al navegador utilizar la GPU para calcular. Aquí realiza la inferencia: aplicar los pesos de un modelo para producir un embedding o generar texto. Esta ejecución local evita llamar a una API de generación alojada para cada respuesta. Requiere un navegador, controladores y recursos GPU compatibles, en una página HTTPS.
La existencia de navigator.gpu no basta. La aplicación comprueba el adaptador físico y rechaza un adaptador de software alternativo. Los ensayos reales utilizaron la Adreno 830 del Samsung Galaxy S25 Ultra en Samsung Internet y una GPU NVIDIA Ampere en ordenador. Las capacidades y los límites de buffers varían: la marca del navegador o la memoria total del teléfono no garantizan que un formato funcione.
Gemma 4 E2B utiliza LiteRT-LM, con @litert-lm/core fijado en 0.17.1, backend GPU_ARTISAN explícito, contexto de 4.096 tokens y thinking desactivado. La API Web LiteRT-LM sigue siendo una versión preliminar, validada aquí en los dispositivos probados. Los embeddings E5 siguen otra ruta: ONNX Runtime Web con WebGPU. Antes de esta elección se probaron varios exports ONNX, WebLLM/MLC y motores compactos.
Los motores compactos experimentales también requirieron trabajo en shaders WGSL, pesos cuantificados y caché de estados. La ruta Nanbeige 4.2 debe respetar las dos pasadas de su arquitectura: eliminar una para ahorrar tiempo no sería una optimización equivalente. Un formato ligero o un modelo pequeño no basta; sus operaciones deben ejecutarse correctamente en esa GPU y mantener una cadena RAG fiable.
La integración requirió dos Web Workers independientes. El SDK LiteRT usa importScripts y arranca en un worker clásico; el worker de embeddings es un módulo JavaScript. Esto mantiene el modelo de respuesta cargado durante la búsqueda E5 y la interfaz disponible. La cancelación cubre ambos workers; una pérdida de GPU libera los motores y muestra un error útil.
CONOCIMIENTOS
El CMS selecciona páginas publicadas, fichas de conocimiento autorizadas e información de formularios admisibles. El texto preparado se divide con el tokenizer real del embedding: fragmentos de 400 tokens con solapamiento de 40 tokens, título limitado y comprobación de 512 tokens tras añadir el prefijo. Un fragmento demasiado largo se rechaza en lugar de perder información silenciosamente.
Multilingual E5 Base, perfil seleccionado, produce vectores de 768 dimensiones. Se utiliza query: para preguntas y passage: para documentos. La salida aplica media enmascarada y normalización L2. La indexación y la búsqueda deben realizar las mismas operaciones: un vector con la longitud correcta puede ser numéricamente incorrecto.
En móvil, la ruta MatMulInteger de ciertos exports cuantificados no era compatible con el motor empleado. Una herramienta reproducible conserva los pesos INT8 pero adapta las operaciones matriciales a FP32 portable. Los artefactos E5 se verifican mediante SHA-256 y cuatro referencias numéricas, con coseno mínimo de 0,999. Las referencias se calculan fuera del navegador; la inferencia del visitante sigue utilizando WebGPU.
MariaDB conserva los vectores en una columna VECTOR(1024). Las dimensiones restantes se rellenan con ceros, manteniendo el coseno. Cada índice está vinculado a su perfil de embedding y cada fragmento a su huella de contenido. Los lotes obsoletos y los vectores no normalizados se rechazan.
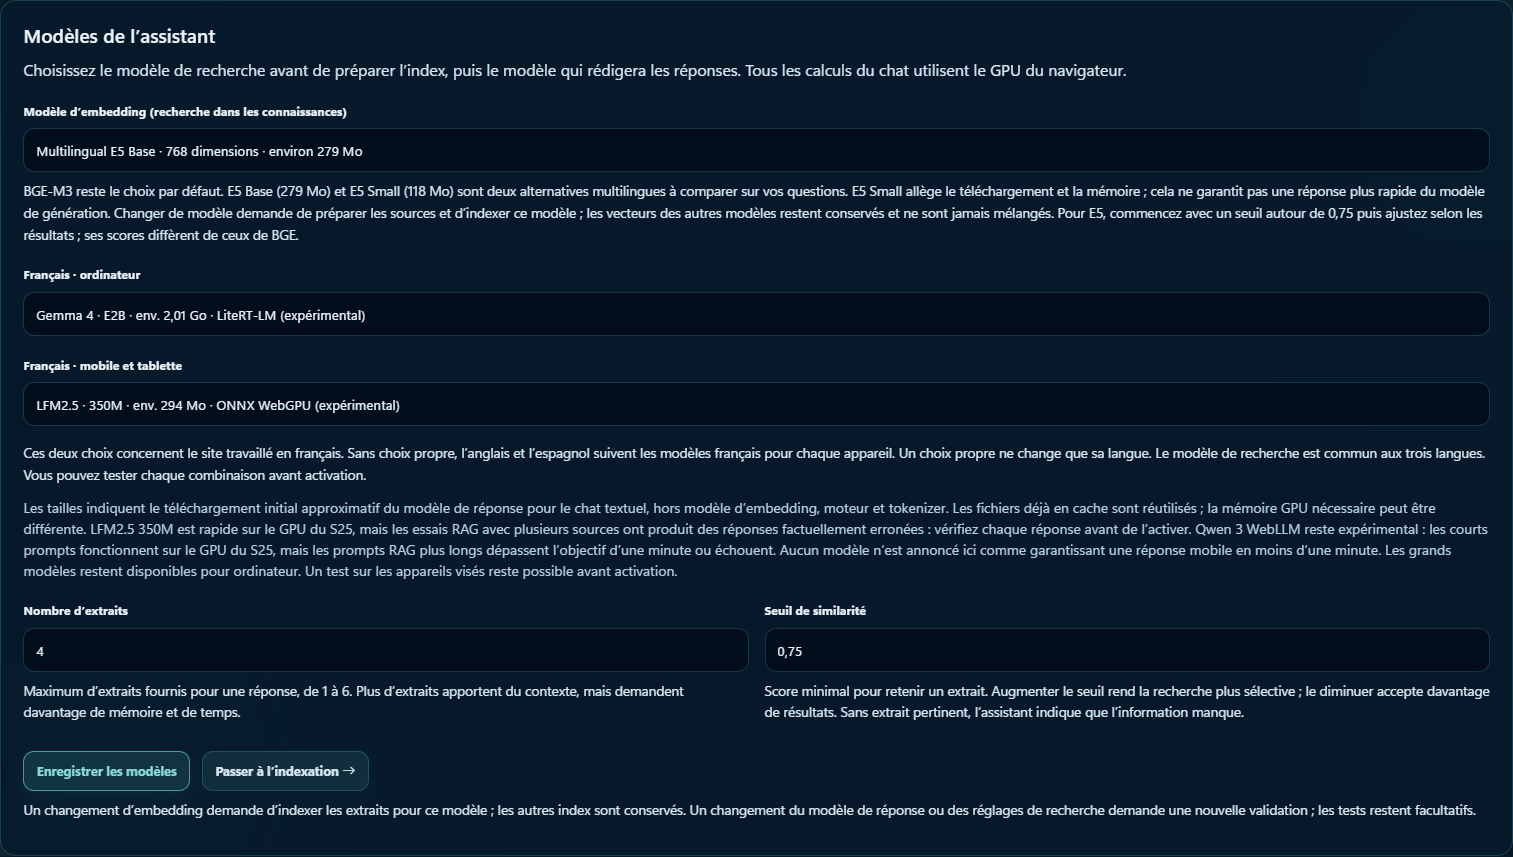
En cada pregunta, el servidor ordena por distancia coseno, filtra el idioma y las fuentes aún publicadas, aplica el umbral configurado y limita los fragmentos de un mismo documento. La configuración ilustrada conserva cuatro fragmentos y un umbral de 0,75. E5 Small, de 384 dimensiones y unos 118 MB frente a 279 MB de Base, está disponible para nuevos ensayos; requiere su propio índice y no se obtiene recortando vectores Base.
Desde el 3 de octubre, las preguntas sobre precio o plazo favorecen secciones de oferta publicadas que coinciden con el proyecto declarado y contienen el importe o duración en el contexto enviado al modelo. Se mantienen los filtros de sitio, idioma y publicación. Esta clasificación no crea precios ni elimina la necesidad de citar fuentes.
CONTEXTO
Una pregunta como «¿y el mantenimiento?» resulta difícil de buscar sin el tema anterior. Una primera pasada genera una consulta autónoma a partir de la solicitud, los intercambios recientes y la referencia opcional. Se limpia la salida para no convertir comentarios del modelo en consultas. Si falla la reformulación sin error fatal del motor, se puede buscar la pregunta original.
La búsqueda conserva la pregunta y su reformulación cuando aportan consultas distintas. El servidor combina sus clasificaciones mediante reciprocal rank fusion: fusiona los rangos de los fragmentos en vez de dejar que la reformulación sustituya completamente la solicitud. Así se reduce el riesgo de perder un detalle importante.
La memoria persistente es opcional y se guarda en IndexedDB, en el navegador del visitante: hasta 60 intercambios durante 7 días. Cada entrada incluye pregunta, respuesta, vector, idioma, perfil de embedding y fecha. Las entradas caducadas se eliminan al acceder; el usuario puede desactivar o borrar la memoria. Si el almacenamiento no está disponible, la conversación continúa sin persistencia.
Existe además una búsqueda semántica local. El vector de la pregunta actual se compara con preguntas anteriores del mismo idioma y perfil; el mejor resultado que supere el umbral puede enriquecer el contexto. Los intercambios recientes tienen prioridad. Una respuesta antigua generada no se reutiliza como fuente factual: solo la pregunta anterior pertinente aporta contexto distante.
El perfil del visitante es distinto de esta memoria: conserva únicamente un nombre declarado explícitamente, con nombre y apellidos cuando están disponibles. La persistencia es opcional, permanece en el navegador y caduca en un máximo de 90 días sin renovación. Una petición de olvido elimina el nombre. Recordarlo al cambiar de idioma o navegar no depende de un antiguo turno guardado.
CALIDAD
El prompt combina el rol y las instrucciones del CMS, la última solicitud, el historial útil y los fragmentos recuperados. Las fuentes se presentan como datos separados de las instrucciones del sistema. El borrador permanece privado: la interfaz muestra el progreso y después la respuesta aceptada. La espera incluye varias pasadas de inferencia, no solo la redacción visible.
Una segunda pasada del mismo modelo evalúa si el borrador responde a la pregunta y si las fuentes sostienen los datos esenciales. LiteRT utiliza la herramienta local emit_result para los intercambios estructurados, sin acción externa. Se validan el JSON y los tipos requeridos. Un JSON válido no garantiza que el juicio sea correcto.
Un fallo real mostró contextos distintos: el redactor veía hasta 1.250 caracteres por fragmento, pero el revisor solo 650. Un rango de precios situado más abajo podía faltar durante la revisión. Ambas pasadas reciben ahora las mismas fuentes con el límite de 1.250 caracteres, evitando exigir una comprobación con pruebas que se han ocultado al revisor.
Si se rechaza el borrador, puede ejecutarse una búsqueda correctiva y redactarse una segunda versión. El proceso tiene límites: dos borradores como máximo y una búsqueda adicional. También se filtran repeticiones y comentarios internos. Si no hay una respuesta admisible, se explica la limitación y se ofrece contacto.
Se conservan los contadores nativos; se rechazan salidas vacías o que alcancen el límite de tokens. No se inventa una señal de finalización que el SDK no exponga. El control reduce algunos errores, pero utiliza el mismo modelo y también puede equivocarse. Se prueba con borradores falsos y datos ausentes; las fuentes siguen siendo consultables.
Los controles locales adicionales rechazan precios sin un importe presente en la oferta solicitada, importes tomados de otra oferta y ciertos marcadores de comentarios internos. Cubren casos concretos: no demuestran todas las condiciones comerciales ni hacen infalible el juicio del modelo.
03 / CMS
El CMS reúne los ajustes que mantienen útil al asistente: conocimientos, comportamiento, modelos y apariencia.
Selección de contenidos, información complementaria y preparación del índice documental.
Modelos de respuesta distintos para móvil y ordenador, seleccionados en el cliente. El modelo de embeddings es configurable.
Pruebas de respuesta y validación en la administración antes de ofrecer el asistente al público.
Nombre, bienvenida, instrucciones y funciones disponibles, con opción de orientar la petición hacia un contacto.
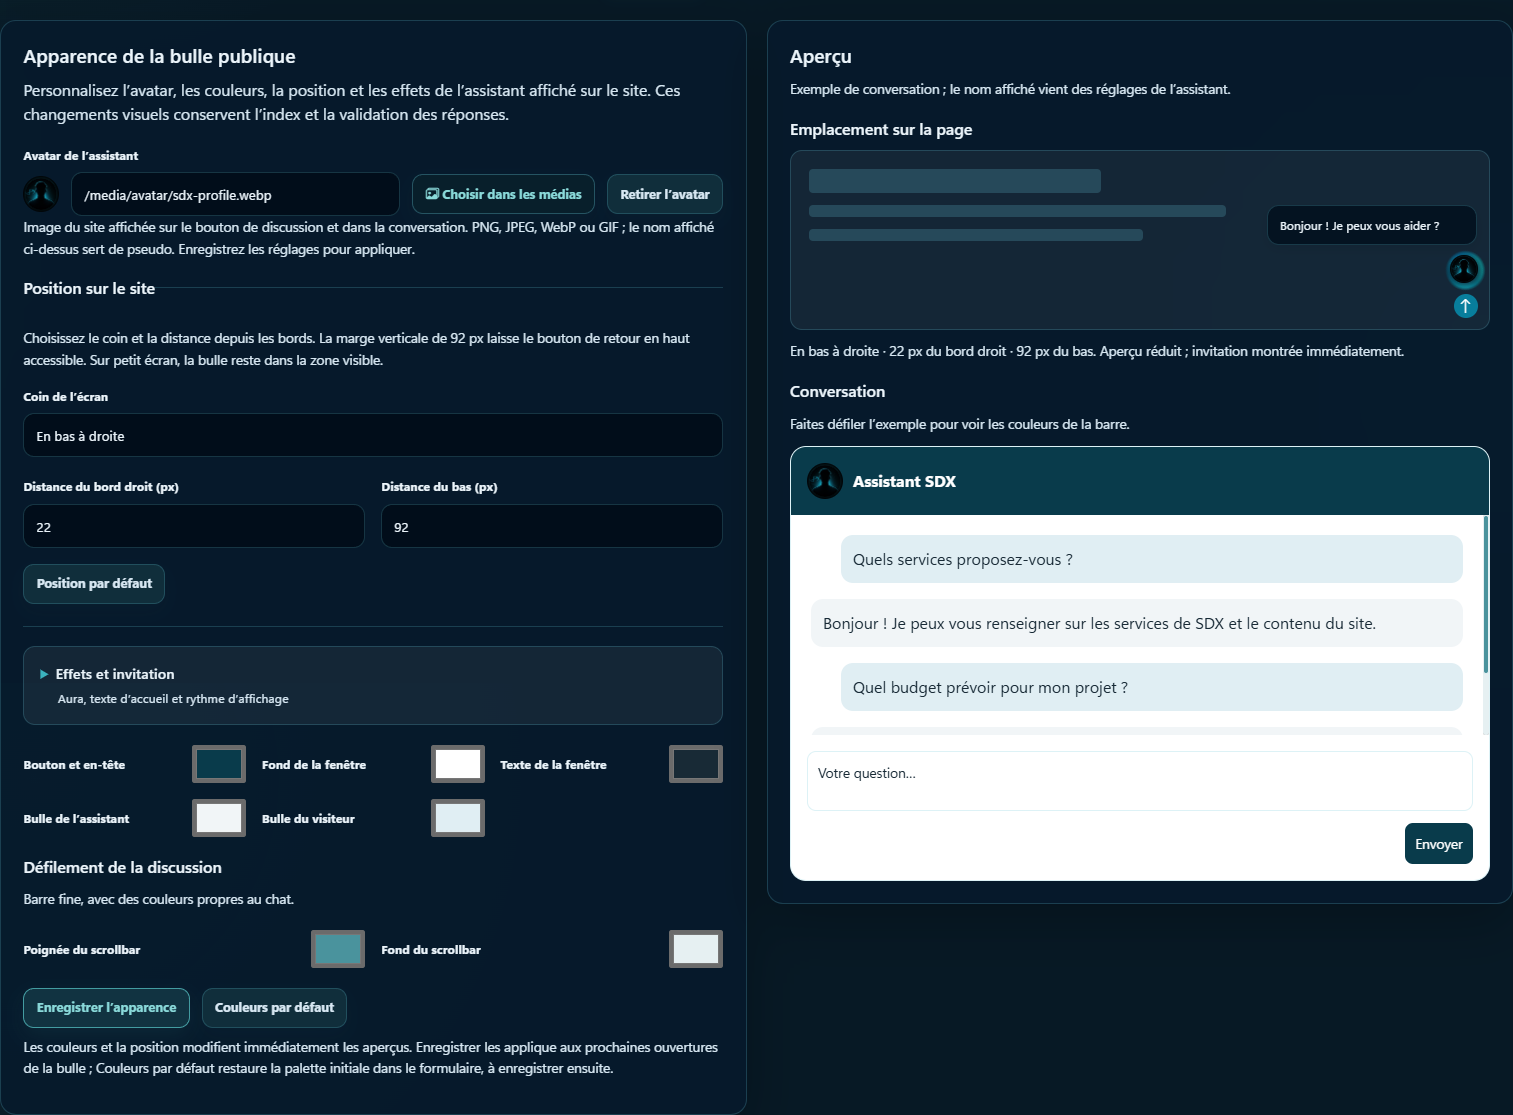
Colores, avatar, posición y vista previa. Aura ajustable: movimiento, dirección, velocidad y expansión máxima.
Las preguntas no cubiertas ayudan a identificar conocimientos que añadir antes de volver a probar el recorrido.
Capturas del CMS en producción desde Chrome, el 3 de octubre de 2026, sin modificar ajustes. El encuadre excluye la barra de cuenta. El formulario de conocimientos está vacío; la vista de apariencia muestra una conversación de demostración.
 Ampliar captura
 Ampliar captura
 Ampliar captura
04 / MOBILE
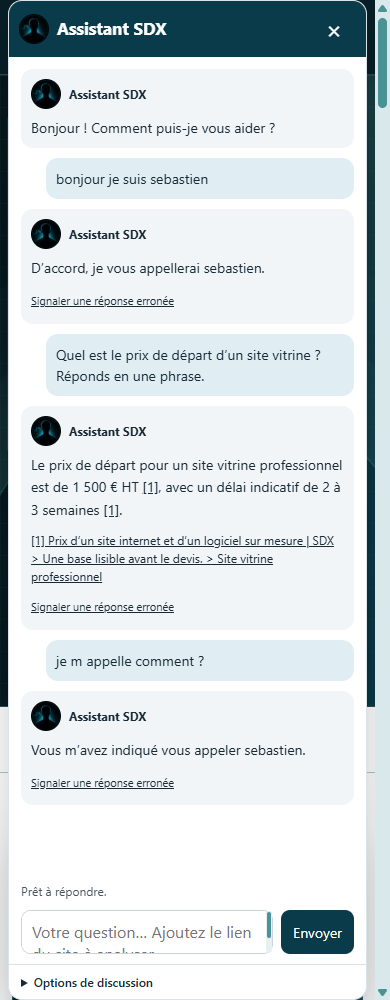
Shadow DOM aísla el widget de los estilos del sitio. En Android, la lectura exige seguir el teclado y la zona realmente visible.
La ventana utiliza la altura disponible y oculta launcher-shell durante la conversación. Los controles secundarios quedan plegados para dejar espacio a los mensajes.
VisualViewport aporta altura y desplazamiento cuando se abre el teclado Android. La ventana los sigue; el campo crece de 44 a un máximo de 96 px y el envío queda accesible.
Screen Wake Lock se solicita durante la conversación, se recupera al volver al primer plano y se libera al cerrar. El navegador o el sistema pueden rechazarlo; no cambia ajustes permanentes del teléfono.
 Ampliar captura
en ordenador, para las dos preguntas de precio después del primer cálculo
05 / Medir en móvil y ordenador
El 3 de octubre de 2026 se planteó la misma pregunta de precio tres veces en una conversación en francés, con los modelos guardados y los archivos ya en caché. En el ordenador con RTX 3070 Ti, Gemma respondió en 11 segundos y después en 7 segundos. En el Galaxy S25 Ultra conectado, LFM mostró una respuesta en 22 segundos y después en 14–17 segundos.
El cronómetro abarca desde el envío hasta que la interfaz está lista: búsqueda real, redacción, control y visualización. El primer cálculo incluye la preparación de los motores, sin descarga inicial de pesos. Tres solicitudes consecutivas no garantizan un plazo para otras preguntas, dispositivos o navegadores.
| Dispositivo y modelo | Primer precio | Dos precios siguientes | Generación con lectura del contexto | Calidad observada |
|---|---|---|---|---|
| Ordenador · RTX 3070 Ti · Chrome 154 · Gemma 4 E2B | 11,0 s | 7,0 s / 6,9 s | 28,2–30,0 tokens/s | 1.500 € sin IVA con cita; retoma correctamente el plazo corporativo de 2–3 semanas. |
| Galaxy S25 Ultra · Android 16 · Samsung Internet 30 · LFM2.5-350M | 22,2 s | 14,2 s / 17,3 s | 3,6–4,4 tokens/s | Encuentra los 1.500 €, sin aclaración del IVA ni cita; plazo corporativo erróneo. |
Pregunta común, planteada en francés: « Quel est le prix de départ d’un site vitrine ? Réponds en une phrase. » Las dos solicitudes siguientes mantienen la misma conversación sin recargar la página. El historial crece; los modelos y navegadores difieren. Las pruebas usan la configuración pública y la búsqueda real del sitio, sin fragmentos ni respuestas simulados.
La tabla muestra las dos redacciones siguientes: tokens de salida nativos divididos por la duración de generación, incluida la lectura del contexto. Los contadores incluyen los elementos técnicos de salida; búsqueda, carga del modelo, revisión y animación quedan fuera de este rendimiento. Gemma produce 58 tokens con 1.946–2.010 tokens de entrada; LFM produce 19 tokens con 1.809–1.852 tokens de entrada.
El SDK LiteRT también ofrece el rendimiento de decodificación de Gemma: 41–44 tokens/s en estas dos respuestas. El motor ONNX usado aquí no devuelve un contador separado para esa fase, por lo que su rendimiento publicado incluye la lectura del contexto. No se estima el rendimiento del texto visible a partir del número de palabras.
La pregunta posterior sobre el plazo tarda 9,0 segundos en ordenador y 19,2 segundos en móvil. El ordenador da las 2–3 semanas de la oferta corporativa; LFM da por error 8–14 semanas, el plazo e-commerce. El precio e-commerce aparece en 6,4 segundos en ordenador y 16,8 segundos en móvil: 12.000 € sin IVA con cita en ordenador, sin aclaración del IVA ni cita en móvil. La presentación y el recuerdo del nombre tardan unos 0,7 segundos en cada dispositivo, sin llamada al motor IA.
Configuración en producción a 3 de octubre de 2026: LFM2.5-350M para móvil y tableta, Gemma 4 E2B para ordenador, E5 Base para búsqueda. Las medidas actuales figuran arriba. La tabla de septiembre mantiene las antiguas pruebas Gemma en S25 como resultados históricos.
Medidas del 27 de septiembre de 2026. Las duraciones cubren una solicitud RAG hasta la respuesta revisada, con pesos ya descargados. Incluyen búsqueda y varias pasadas, no solo decodificación.
| Dispositivo / candidato | Duración observada | Resultado |
|---|---|---|
| S25 Ultra · Samsung Internet · Gemma 4 E2B | 36,11 s | Pregunta de precio: respuesta completa y revisada, 1.500–5.000 € sin IVA. |
| Ordenador · Chrome / NVIDIA Ampere · Gemma 4 E2B | 12,25 s | Misma pregunta: 114 tokens; el control también rechaza un precio falso. |
| Mismo ordenador · Nanbeige 4.2 Compact | 120,73 s | Respuesta nominal correcta, 238 tokens; aceptación errónea del borrador falso. |
| Mismo ordenador · Gemma E2B · validación final | 13,06 s | Prueba real registrada en el CMS y activación del modelo común a ambos perfiles. |
Las respuestas tienen distinta longitud y la reformulación puede cambiar los fragmentos recuperados: no es una clasificación universal. El contraensayo presentaba 15.000–100.000 € frente a fuentes de 1.500–5.000 €. La respuesta simple correcta de Nanbeige no bastaba para validar su revisor.
Gemma E2B también trató una objeción de precio en 15,02 s y mantenimiento en 12,99 s. Una promesa falsa «24 horas por 100 euros» y una facturación exacta no publicada terminaron en contacto humano en 25,91 s y 23,59 s. No inventar información formaba parte de la prueba.
Los ensayos móviles mostraron que una descarga pequeña no garantiza una cadena fiable: varios candidatos perdieron la GPU, repitieron texto o fallaron la revisión. Los exports ONNX probados de Qwen 3.5 4B y Gemma 3 4B no dieron respuesta final en ordenador en esta ruta. Esto describe esos exports y motores, no todos los usos de esos modelos.
Los embeddings se midieron por separado en el S25 con pesos en caché: Base, 4,275 s para carga, comprobaciones y primera pregunta, después 90–103 ms; Small, 3,487 s y después 24–27 ms. El pequeño ensayo de clasificación utilizaba cinco fragmentos, no los 855 del sitio. La mayor espera procedía de las pasadas de respuesta: cambiar solo el embedding no la habría resuelto.
DATOS
La inferencia de respuesta y la memoria persistente se ejecutan en el dispositivo. El servicio sigue conectado: descarga modelos y bibliotecas, envía vectores de búsqueda y recibe textos fuente. Un embedding no garantiza anonimato. Las preguntas no cubiertas pueden guardarse en el CMS para mejorar conocimientos, hasta 90 días sin una nueva solicitud y con un máximo de 5.000 preguntas por sitio.
Las API controlan el ámbito del sitio, las sesiones de administración y las protecciones CSRF correspondientes. Se comprueban perfil, dimensiones, valores finitos y normalización de los vectores. La búsqueda excluye páginas retiradas y formularios no autorizados; las fichas en borrador no se publican en las respuestas.
Cuando se activa la lectura de referencias web, el servidor puede leer una URL pública del visitante. Se verifican protocolos, direcciones y redirecciones para bloquear redes privadas. La descarga tiene límites de tamaño y tiempo. Se extrae texto sin ejecutar scripts; sigue siendo una referencia externa, no una instrucción del sistema.
La referencia también puede ser la página pública abierta: el cliente proporciona su título y URL cuando una pregunta la señala. Una URL explícita del visitante tiene prioridad. La lectura conserva las mismas protecciones del servidor que las demás referencias web; nunca se usan direcciones de administración como páginas para resumir.
El asistente puede ayudar a completar un formulario autorizado con información expresamente facilitada. Se validan esquema de campos, idioma, formulario y duración de validez. Se preservan los valores existentes, nunca se marca automáticamente el consentimiento y no se envía ningún formulario sin acción del usuario.
PUBLICACIÓN
El CMS prepara las fuentes, retoma la indexación, sigue los fragmentos pendientes y ofrece una prueba real. Los perfiles de respuesta móvil/tableta y ordenador son independientes. La detección utiliza información del navegador y del dispositivo: estrechar una ventana de ordenador no cambia al perfil móvil.
Un cambio de modelo, instrucciones o índice invalida la aprobación correspondiente. Las fuentes modificadas deben prepararse y sus nuevos pasajes indexarse antes de validar y reactivar el asistente. Una prueba real es recomendable, pero sigue siendo opcional en el CMS actual. Las firmas de configuración impiden conservar una aprobación anterior tras un cambio; los ajustes solo visuales la conservan.
La verificación incluyó generación real en GPU, coherencia numérica de embeddings, precios y mantenimiento, promesas falsas y cifras no publicadas. Las correcciones móviles se comprobaron con teclado abierto, apertura y cierre de la ventana, botón de envío accesible y ausencia de desbordamiento. La publicación respalda el ámbito afectado y verifica las páginas públicas.
Quedan objetivos concretos: ampliar preguntas de validación, medir descargas iniciales y cuotas, comprobar más combinaciones navegador/GPU y comparar nuevos exports sobre Adreno. Una aplicación nativa podría usar otros aceleradores; la inferencia alojada reduciría la carga del teléfono. Estas alternativas cambiarían la arquitectura y no se presentan como ya entregadas.
Las decisiones y medidas proceden de las pruebas del proyecto. Estas referencias explican las tecnologías y no garantizan rendimiento en un dispositivo concreto.
El visitante puede consultar los contenidos y verificar las fuentes. El administrador puede ampliar los conocimientos, configurar el asistente y probar sus respuestas. El proyecto cubre toda la cadena, desde la edición del contenido hasta su uso en una conversación.
Descubrir los servicios de IA y RAG
Software y productos de gestión
Un ERP que conecta expedientes, planificación con restricciones, inventario, facturación y portal de clientes, con ITS Report para la inspección por vídeo.
Explorar el proyecto : Idea to Software
Sitios web profesionales
Una web industrial con CMS a medida: contenidos técnicos, método C.A.R.E., referencias, franquicia y solicitudes de diagnóstico.
Explorar el proyecto : Résiliner¿Y tu proyecto?
Documentación, catálogo, procedimientos o servicios: definamos las fuentes, los usuarios y las respuestas esperadas para crear un asistente útil para tu actividad.
Introduce al menos 2 caracteres para iniciar la búsqueda.