Choisir les connaissances
Sélection des contenus, ajout d’informations complémentaires et préparation de l’index documentaire.
Assistant IA RAG · SDX
Une bulle de discussion intégrée au CMS : échanges simples traités localement, recherche documentaire à la demande et réponses générées sur le GPU du visiteur.
Toutes les réalisations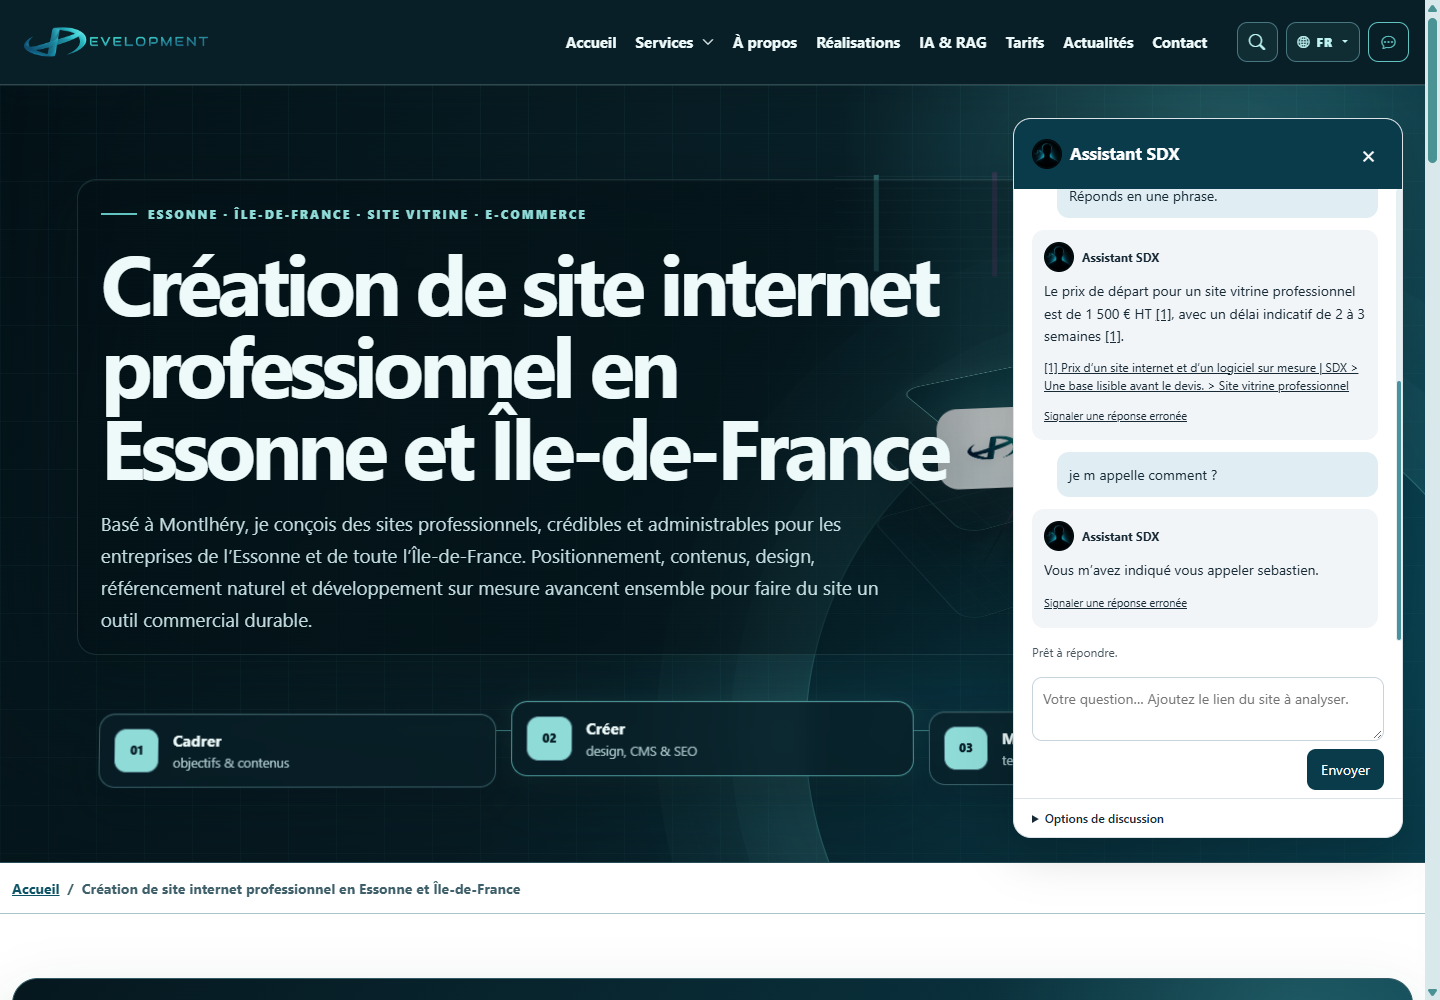 Agrandir la capture
01 / RAG
Les pages d’un site expliquent une offre, ses tarifs et son fonctionnement. Pourtant, le visiteur ne sait pas toujours où chercher. L’objectif était de lui permettre de poser sa question et de retrouver une réponse reliée aux informations publiées.
J’ai conçu cette application sur le propre site de SDX Development. C’est une réalisation interne, accessible en production, qui réunit recherche documentaire, modèles locaux, administration des connaissances et interface de conversation.
MISE À JOUR · 3 OCTOBRE 2026
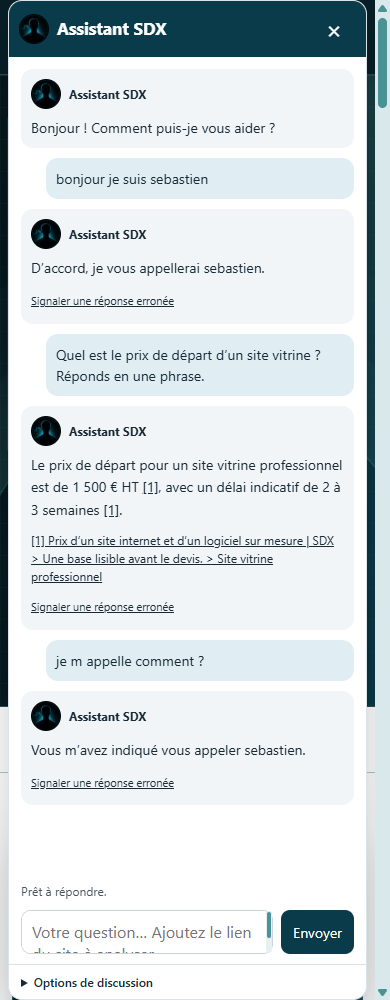
Les salutations, remerciements et échanges autour du nom ont désormais un parcours local, sans charger le modèle ni lancer de recherche documentaire. « Bonjour, je suis Sébastien » permet de reprendre le prénom ; « je m’appelle comment ? » rappelle le nom déclaré au lieu de le prendre pour un nouveau nom.
Le RAG intervient lorsque des connaissances sont utiles. Les questions de suivi sur un prix ou un délai reprennent le projet explicitement décrit par le visiteur. Les fiches d’offre qui contiennent le montant ou la durée demandés sont mieux classées, pour limiter les confusions avec un autre type de prestation.
Une demande comme « résume cette page » prend en compte la page publique ouverte, son titre et son adresse. La lecture passe par le serveur et ses protections sur les URL ; un lien donné explicitement par le visiteur reste prioritaire. Ce contexte ne transforme pas une page en consigne pour le modèle.
Le nom peut être conservé dans un profil local facultatif, distinct de l’historique de discussion. Après navigation ou deux minutes d’inactivité lorsque la discussion est fermée, une invitation apparaît près de la bulle et peut reprendre ce nom. Elle n’ouvre pas automatiquement la fenêtre de conversation.
Les premiers essais du 3 octobre ont vérifié la présentation, le rappel du nom, le résumé de page et des questions de tarifs et délais sous Chrome Windows. Un nouvel essai a ensuite utilisé le téléphone Galaxy S25 Ultra réellement connecté et le PC : la section Mesures donne les temps complets, les tokens/s et les défauts constatés avec les modèles enregistrés.
Le petit modèle mobile reste une limite du projet. Il peut encore refuser une réponse de tarif malgré une source correcte. Des contrôles supplémentaires bloquent certaines omissions de prix, des montants associés à une autre offre et des commentaires internes, mais le vérificateur sémantique peut accepter des erreurs. Qwen3-0.6B a été comparé sans remplacer le modèle en production : avec les prompts testés, son contrôle acceptait quatre brouillons incorrects sur six.
02 / RAG
La conversation commence sans recherche pour les échanges simples. Quand la demande porte sur les contenus ou les prestations, le RAG relie la réponse aux sources : le navigateur et le serveur du site se partagent alors le travail.
Le CMS prépare un index à partir des contenus sélectionnés et des connaissances ajoutées par l’administrateur.
Le navigateur calcule une représentation de la question. Le serveur recherche les passages pertinents dans l’index et renvoie leurs sources.
Le modèle exécuté dans le navigateur rédige une réponse à partir des passages retrouvés. Une recherche complémentaire peut enrichir le contexte.
Un contrôle local examine le brouillon avant son affichage. Si les tentatives bornées ne donnent pas de réponse admissible, l’assistant indique la limite et peut proposer un contact.
La génération s’exécute sur l’appareil du visiteur, avec accès au GPU. Le service n’est pas entièrement hors ligne : il télécharge des modèles et interroge le serveur pour retrouver les sources. Les questions sans réponse peuvent être conservées pour compléter les connaissances.
Le serveur conserve les connaissances et recherche les passages. Le navigateur exécute les modèles de reformulation, d’embedding, de rédaction et de contrôle. La mémoire de conversation est une troisième ressource, locale et facultative : elle aide à suivre la demande, sans remplacer les sources documentaires.
La demande actuelle, le projet explicitement décrit, les derniers échanges et une éventuelle référence publique. Les échanges simples sur le nom ou les salutations peuvent être traités localement avant ce parcours RAG.
Le modèle transforme la demande en une requête documentaire autonome. La question d’origine est conservée à côté de la reformulation.
Les requêtes deviennent des vecteurs numériques calculés sur WebGPU. Ce sont ces vecteurs qui partent vers l’API du site.
L’index sélectionne les passages de la bonne langue, applique le seuil de similarité et fusionne les classements. Retour : textes, titres et liens des sources.
Si le visiteur l’autorise, une ancienne question proche est retrouvée dans IndexedDB. Elle complète les échanges récents, sans importer son ancienne réponse comme preuve.
Le modèle de réponse utilise les consignes du CMS, la question, le contexte de conversation et les passages retrouvés. Rien de ce brouillon n’est encore affiché.
Le même modèle confronte le brouillon aux sources. En cas de refus : au plus une nouvelle recherche et une seconde tentative de rédaction.
Le brouillon accepté est affiché avec les sources. À défaut d’information suffisante, un relais humain est proposé. Un échange admissible peut être mémorisé localement.
Avant les questions : l’administrateur prépare les contenus et calcule leurs embeddings dans son navigateur. Les vecteurs documentaires sont enregistrés sur le serveur ; chaque visiteur calcule les vecteurs de ses questions, sans réindexer les pages du site.
EXÉCUTION
WebGPU donne au navigateur un accès aux calculs du GPU. Dans ce projet, il sert à l’inférence : appliquer les poids d’un modèle pour produire un embedding ou générer du texte. Cette exécution locale évite d’appeler une API de génération hébergée à chaque réponse. Elle demande cependant un navigateur, un pilote et des ressources GPU compatibles, sur une page servie en HTTPS.
La présence de navigator.gpu ne suffit pas. L’application vérifie l’adaptateur matériel et refuse un adaptateur logiciel de secours. Les essais physiques ont notamment utilisé l’Adreno 830 du Samsung Galaxy S25 Ultra sous Samsung Internet et un GPU NVIDIA Ampere sur ordinateur. Les capacités et les limites de buffers peuvent varier : la marque du navigateur ou la mémoire totale du téléphone ne prouvent pas qu’un export fonctionnera.
Le moteur retenu pour Gemma 4 E2B est LiteRT-LM, avec le SDK @litert-lm/core fixé à la version 0.17.1, le backend GPU_ARTISAN explicitement demandé, une fenêtre de 4 096 tokens et le mode thinking désactivé. L’API Web LiteRT-LM reste une préversion, qualifiée ici sur les appareils testés. Les embeddings E5 suivent un autre chemin : ONNX Runtime Web avec WebGPU. Plusieurs exports ONNX, WebLLM/MLC et moteurs compacts ont été évalués avant ce choix.
Les moteurs compacts expérimentés ont également demandé du travail sur les shaders WGSL, les poids quantifiés et le cache des états du modèle. Le chemin Nanbeige 4.2 doit notamment respecter les deux passages prévus par son architecture : supprimer une passe pour gagner du temps ne serait pas une optimisation équivalente. Un format léger ou un modèle plus petit ne suffit donc pas ; il faut que ses opérations soient correctement exécutées par ce GPU et que le parcours RAG reste fiable.
L’intégration a nécessité deux Web Workers distincts. Le SDK LiteRT utilise importScripts et démarre dans un worker classique ; le worker des embeddings est un module JavaScript. Cette séparation garde le modèle de réponse chargé pendant la recherche E5 et laisse l’interface réactive. L’annulation couvre les deux workers ; une perte du GPU libère les moteurs et signale une erreur exploitable au visiteur.
CONNAISSANCES
Le CMS sélectionne les pages publiées, les fiches de connaissances autorisées et les informations de formulaires admissibles. Leur texte est préparé puis découpé avec le véritable tokenizer du modèle d’embedding : passages de 400 tokens avec un recouvrement de 40 tokens, titre borné et vérification de la limite de 512 tokens après ajout du préfixe. L’application refuse un extrait trop long au lieu de tronquer silencieusement les informations.
Le profil actuellement sélectionné, Multilingual E5 Base, produit des vecteurs de 768 dimensions. Les entrées distinguent query: pour une question et passage: pour un document. Les sorties suivent un pooling moyen masqué et une normalisation L2. Ces opérations doivent être identiques à l’indexation et à la recherche : un vecteur de bonne longueur peut néanmoins être numériquement incorrect.
Sur mobile, le chemin MatMulInteger de certains exports quantifiés n’était pas compatible avec le moteur utilisé. Un outil de préparation reproductible conserve les poids INT8 mais adapte les opérations matricielles vers le chemin FP32 portable. Les artefacts E5 sont contrôlés par SHA-256 et comparés à quatre références numériques, avec un cosinus attendu d’au moins 0,999. Ces références sont calculées hors du navigateur ; l’inférence du visiteur reste sur WebGPU.
Les vecteurs sont stockés dans MariaDB, dans une colonne VECTOR(1024). Les dimensions restantes sont complétées par des zéros, ce qui conserve le calcul du cosinus. Chaque index reste associé à son profil d’embedding et chaque passage à son empreinte de contenu. Un lot périmé ou un vecteur non normalisé est refusé.
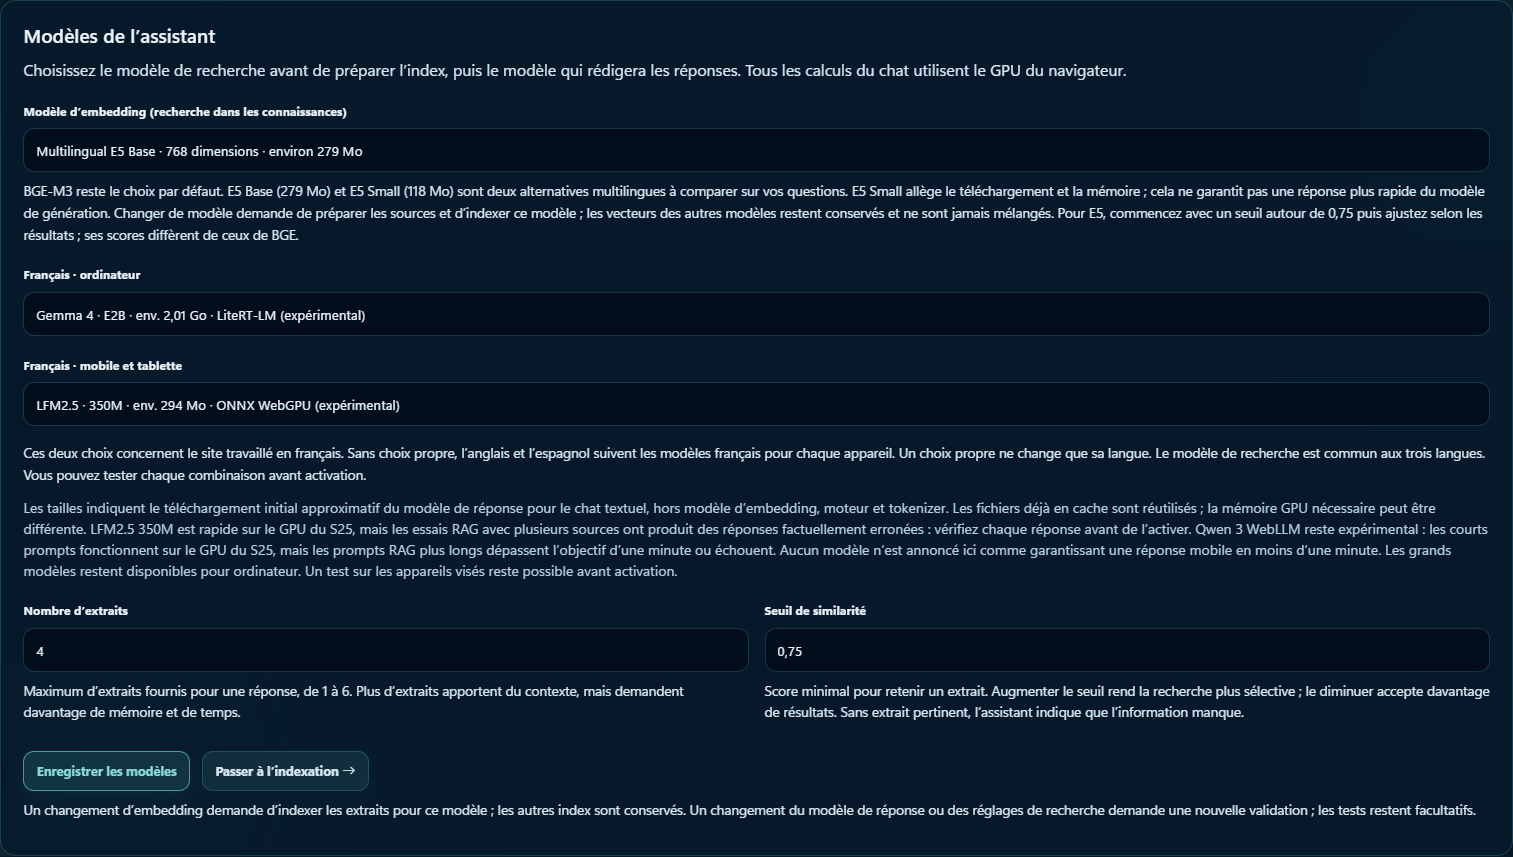
À chaque question, le serveur classe les passages par distance cosinus, filtre la langue et les sources encore publiées, applique le seuil configuré et limite la concentration de passages d’un même document. La configuration illustrée retient quatre extraits avec un seuil de 0,75. E5 Small, 384 dimensions et environ 118 Mo contre 279 Mo pour Base, est disponible pour d’autres essais ; il exige son propre index et ne se déduit pas en raccourcissant les vecteurs Base.
Depuis le 3 octobre, une demande de tarif ou de délai favorise une section d’offre publiée qui correspond au projet déclaré et contient réellement le montant ou la durée dans le contexte transmis au modèle. Les filtres de site, de langue et de publication restent appliqués. Ce classement ne crée pas de prix et ne dispense pas le modèle de citer les sources.
CONTEXTE
Une question de suivi comme « et pour la maintenance ? » devient difficile à rechercher sans le sujet précédent. Une première passe du modèle produit une requête autonome à partir de la demande, des échanges récents et de la référence éventuelle. Le nettoyage de cette sortie évite de transmettre un commentaire du modèle comme requête. Si cette reformulation échoue sans erreur fatale de moteur, la recherche peut repartir de la question d’origine.
La recherche conserve la question et sa reformulation lorsque les deux apportent une requête distincte. Le serveur fusionne leurs classements avec une méthode de reciprocal rank fusion : elle combine les rangs des passages plutôt que de laisser une réécriture remplacer entièrement la demande du visiteur. Le résultat réduit le risque qu’un détail important disparaisse lors de la reformulation.
La mémoire persistante est facultative et stockée dans IndexedDB, dans le navigateur du visiteur : jusqu’à 60 échanges pendant 7 jours. Chaque entrée conserve une question, une réponse, son vecteur, sa langue, son profil d’embedding et sa date. Les entrées expirées sont éliminées lors de l’accès ; l’utilisateur peut désactiver ou effacer cette mémoire. Si le stockage est indisponible, la discussion continue sans persistance.
Cette mémoire comporte une recherche sémantique locale. Le vecteur de la question actuelle est comparé aux anciennes questions de la même langue et du même profil ; le meilleur résultat dépassant le seuil du profil peut enrichir le contexte. Les derniers échanges sont prioritaires. Une ancienne réponse générée n’est pas réinjectée comme une source de faits : seule la question ancienne pertinente sert de contexte distant.
Le profil visiteur est distinct de cette mémoire : il conserve uniquement un nom explicitement déclaré, avec prénom et nom de famille lorsque disponibles. Sa persistance est facultative, reste dans le navigateur et expire au plus tard après 90 jours sans renouvellement. Une commande d’oubli permet de supprimer le nom. Changer la langue ou naviguer ne doit pas faire dépendre le rappel du nom de la présence d’un ancien tour sauvegardé.
QUALITÉ
Le prompt de rédaction assemble le rôle et les consignes configurés dans le CMS, la dernière demande, l’historique utile et les extraits documentaires. Les passages sont présentés comme des données, séparées des instructions système. Le brouillon est privé : l’interface montre l’état de travail, puis la réponse acceptée. Cette attente inclut donc plusieurs passes d’inférence, et pas seulement la rédaction visible.
Une seconde passe du même modèle évalue si le brouillon répond réellement à la question et si les informations essentielles sont soutenues par les sources. Pour LiteRT, les échanges structurés utilisent un outil local emit_result, sans action externe. Le programme vérifie l’objet JSON et les types des champs attendus. Un JSON valide ne prouve toutefois pas que son jugement est juste.
Un cas concret a révélé une différence de contexte : le rédacteur voyait jusqu’à 1 250 caractères par extrait, tandis que le contrôleur n’en voyait que 650. Une fourchette de prix située plus loin pouvait alors manquer au contrôle. Les deux passes utilisent désormais la même limite de 1 250 caractères et les mêmes sources ; ce correctif évite de demander au juge de vérifier une information qu’on lui a retirée.
Si le brouillon est refusé, le parcours peut lancer une recherche documentaire corrective puis rédiger une seconde version. Le nombre de tentatives reste borné : deux brouillons au maximum et une recherche complémentaire. Les répétitions d’anciennes réponses et les commentaires internes sont également filtrés. En l’absence de réponse admissible, l’assistant indique la limite et propose un contact.
Les compteurs natifs de génération sont conservés ; une sortie vide ou atteignant son plafond est refusée. Aucun signal de fin de génération que le SDK n’expose pas n’est fabriqué. Le contrôle local réduit certains défauts, mais utilise le même modèle que le rédacteur : il peut lui aussi se tromper. Il doit être éprouvé avec des brouillons faux et des informations absentes, et les sources restent consultables.
Des contrôles locaux supplémentaires refusent un tarif sans montant présent dans l’offre demandée, un montant emprunté à une autre offre et certains marqueurs de commentaires internes. Ces contrôles couvrent des cas précis : ils ne prouvent pas toutes les conditions commerciales d’une réponse et ne rendent pas le jugement du modèle infaillible.
03 / CMS
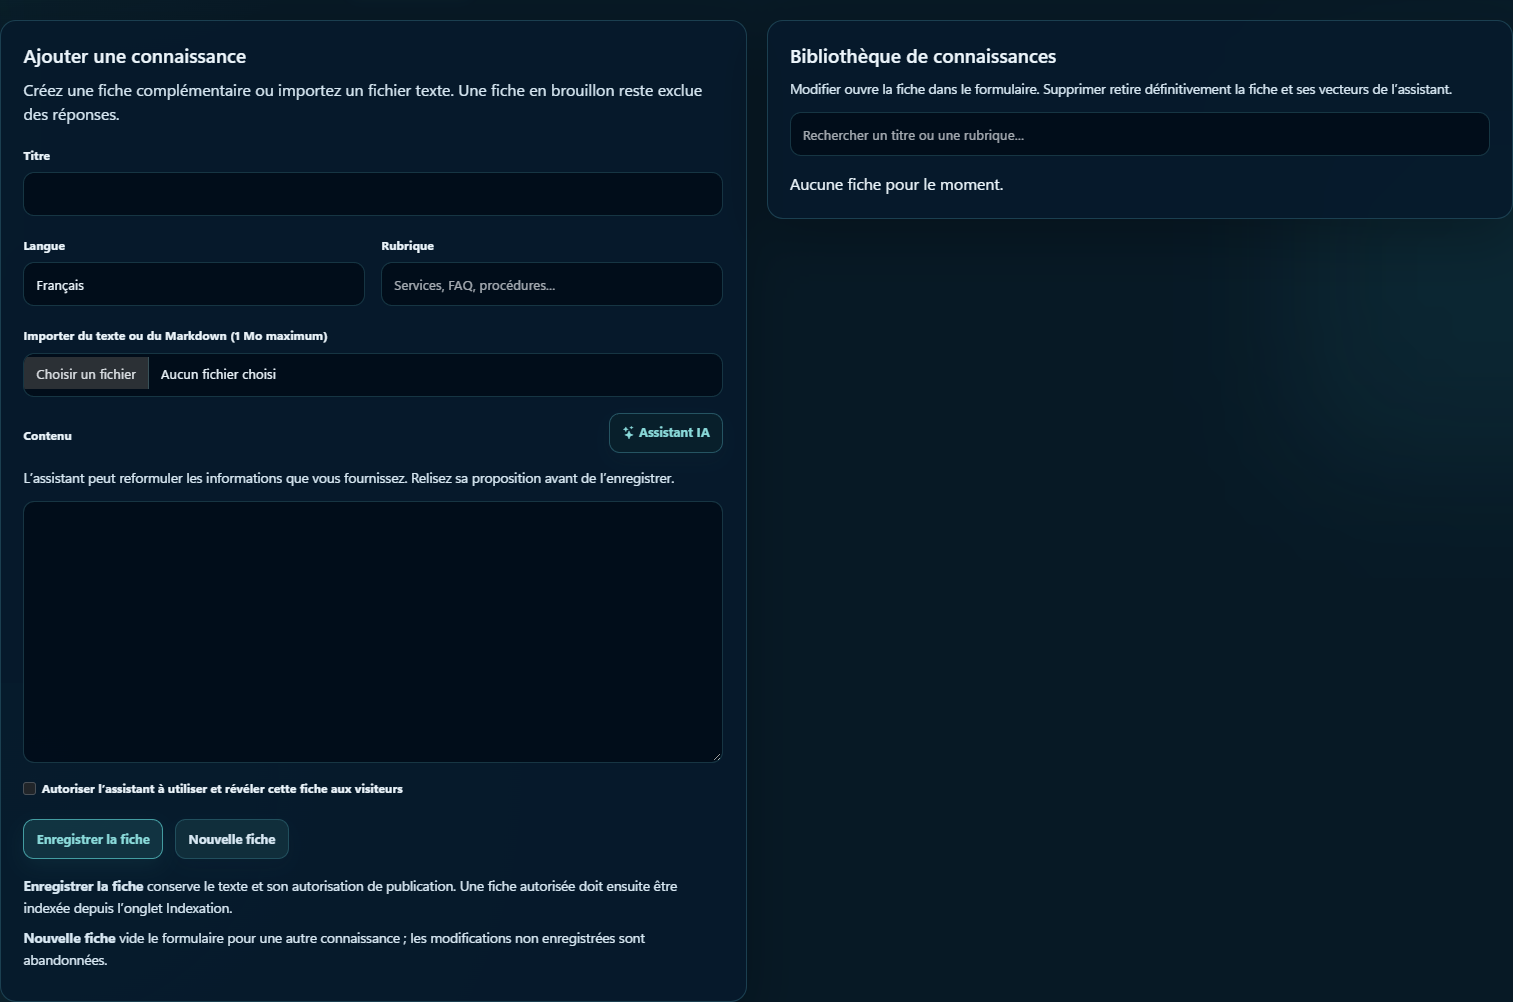
Le CMS rassemble les réglages qui font vivre l’assistant : ses connaissances, son comportement, ses modèles et son apparence.
Sélection des contenus, ajout d’informations complémentaires et préparation de l’index documentaire.
Un modèle de réponse pour mobile et un autre pour ordinateur, sélectionnés côté client. Le modèle d’embedding est configurable.
Tests de réponse et validation dans l’administration avant la mise à disposition de l’assistant.
Nom, accueil, consignes et fonctions disponibles, avec possibilité d’orienter la demande vers un contact.
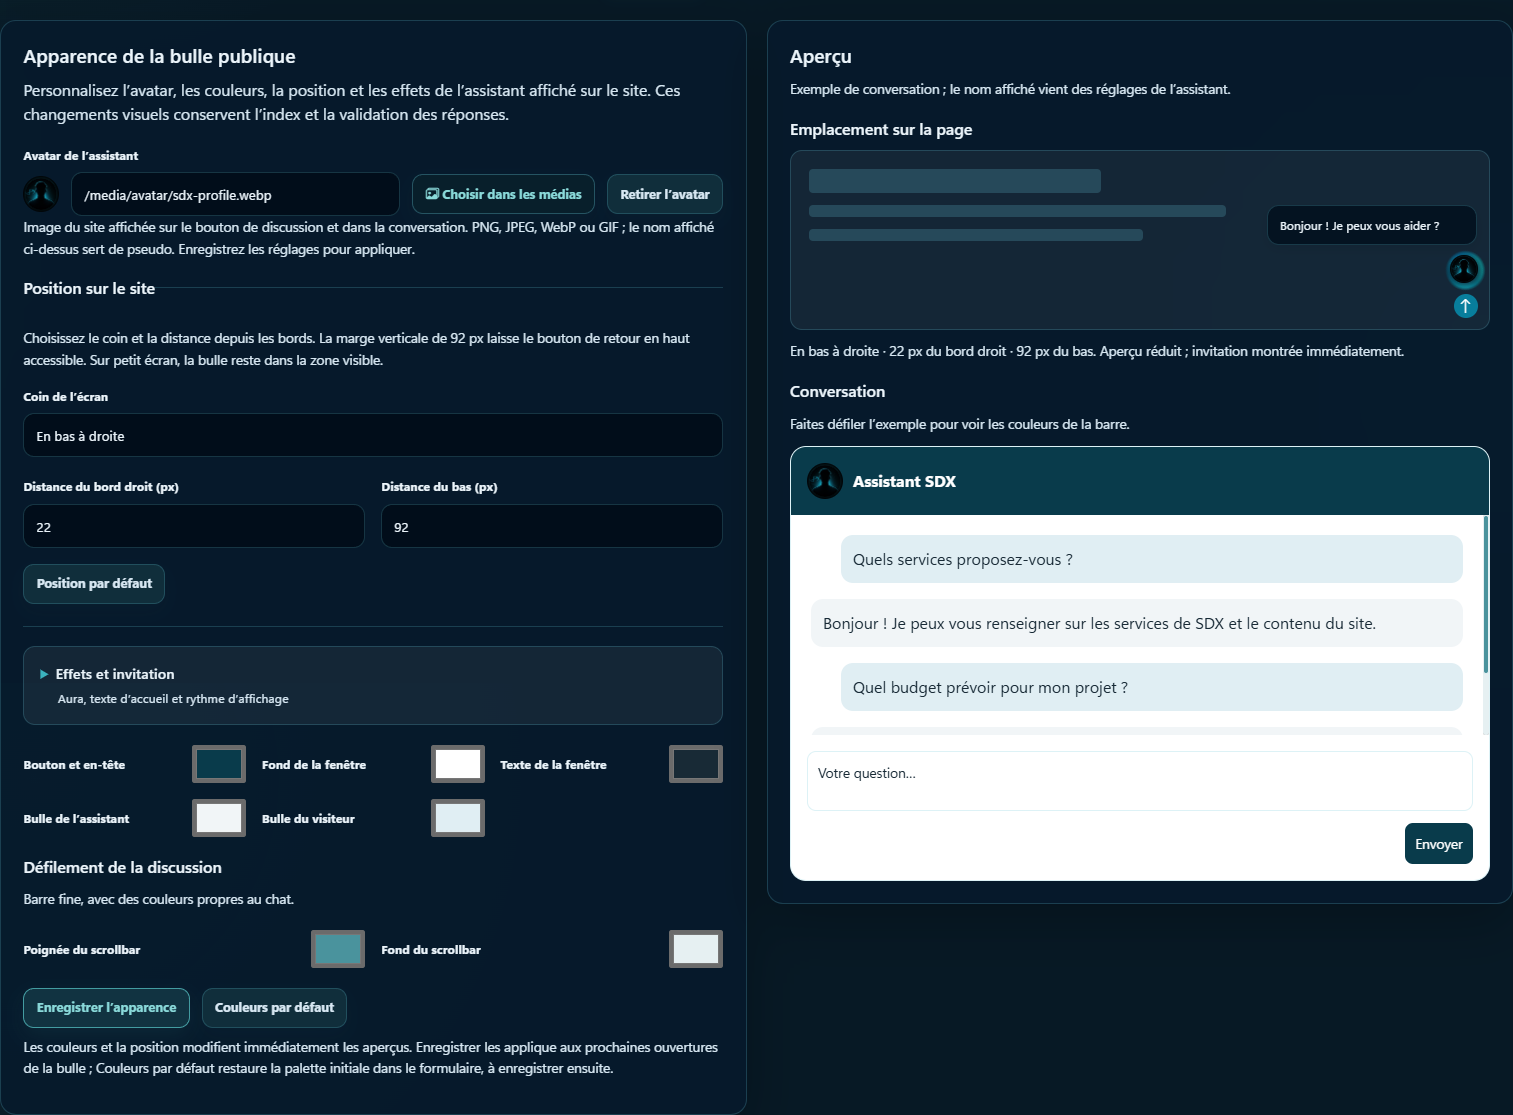
Couleurs, avatar, position et aperçu. Aura réglable : mouvement, direction, vitesse et gonflement maximal.
Les demandes non couvertes aident à repérer les connaissances à enrichir, puis à retester le parcours.
Captures du CMS de production dans Chrome, le 3 octobre 2026, sans modification des réglages. Le cadrage exclut la barre de compte. Le formulaire de connaissance est vide ; l’aperçu d’apparence affiche une conversation de démonstration.
 Agrandir la capture
 Agrandir la capture
 Agrandir la capture
04 / MOBILE
Le widget est isolé dans un Shadow DOM pour éviter les conflits de styles avec le site. Sur Android, une interface lisible exige aussi de suivre le clavier et la zone réellement visible.
La fenêtre utilise toute la hauteur disponible et le lanceur launcher-shell est masqué pendant la discussion. Les commandes secondaires restent repliées pour laisser de la place aux messages.
VisualViewport fournit la hauteur et le décalage de la zone visible quand le clavier Android s’ouvre. La fenêtre les suit ; le champ grandit de 44 à 96 px maximum et le bouton d’envoi reste accessible.
Screen Wake Lock est demandé pendant la discussion, repris au retour au premier plan et relâché à la fermeture. Le système et le navigateur peuvent refuser ce verrou ; aucun réglage permanent du téléphone n’est changé.
 Agrandir la capture
sur PC, pour les deux demandes de prix après le premier calcul
05 / Mesurer sur mobile et ordinateur
Le 3 octobre 2026, la même question de prix a été posée trois fois dans une discussion en français, avec les modèles enregistrés et les fichiers déjà en cache. Sur le PC équipé d’une RTX 3070 Ti, Gemma a répondu en 11 secondes, puis 7 secondes. Sur le Galaxy S25 Ultra connecté, LFM a affiché une réponse en 22 secondes, puis 14 à 17 secondes.
Le chronomètre couvre l’envoi jusqu’au retour de l’interface à l’état prêt : recherche réelle, rédaction, contrôle et affichage. Le premier calcul inclut la préparation des moteurs, mais aucun premier téléchargement des poids. Trois demandes successives ne suffisent pas à garantir un délai sur d’autres questions, appareils ou navigateurs.
| Appareil et modèle | Premier prix | Deux prix suivants | Génération avec lecture du contexte | Qualité observée |
|---|---|---|---|---|
| PC · RTX 3070 Ti · Chrome 154 · Gemma 4 E2B | 11,0 s | 7,0 s / 6,9 s | 28,2–30,0 tokens/s | 1 500 € HT avec citation ; délai vitrine de 2 à 3 semaines correctement repris. |
| Galaxy S25 Ultra · Android 16 · Samsung Internet 30 · LFM2.5-350M | 22,2 s | 14,2 s / 17,3 s | 3,6–4,4 tokens/s | Montant de 1 500 € retrouvé, sans HT ni citation ; erreur sur le délai vitrine. |
Question commune : « Quel est le prix de départ d’un site vitrine ? Réponds en une phrase. » Les deux demandes suivantes restent dans la même conversation, sans rechargement de page. L’historique s’allonge ; les modèles et les navigateurs diffèrent. Ces essais utilisent la configuration publique du site, pas des extraits ou des réponses simulés.
Le débit du tableau est calculé sur les deux rédactions suivantes : nombre de tokens de sortie du moteur divisé par la durée de génération, lecture du contexte incluse. Les compteurs natifs incluent les éléments techniques de sortie ; la recherche, le chargement du modèle, la vérification et l’animation ne sont pas dans ce débit. Gemma produit 58 tokens avec 1 946–2 010 tokens en entrée ; LFM produit 19 tokens avec 1 809–1 852 tokens en entrée.
Le SDK LiteRT donne aussi un débit de décodage seul pour Gemma : 41–44 tokens/s sur ces deux réponses. Le moteur ONNX utilisé ici ne renvoie pas de compteur séparant cette phase ; son débit publié inclut donc la lecture du contexte. Les tokens/s du texte affiché ne sont pas estimés à partir du nombre de mots.
La question de suivi sur le délai prend 9,0 secondes sur PC et 19,2 secondes sur mobile. Le PC donne les 2 à 3 semaines de l’offre vitrine ; LFM donne à tort 8 à 14 semaines, le délai e-commerce. Le prix e-commerce est affiché en 6,4 secondes sur PC et 16,8 secondes sur mobile : 12 000 € HT avec citation côté PC, sans HT ni citation côté mobile. La présentation et le rappel du prénom prennent environ 0,7 seconde sur chaque appareil, sans appel au moteur IA.
Configuration en production au 3 octobre 2026 : LFM2.5-350M sur mobile et tablette, Gemma 4 E2B sur ordinateur, E5 Base pour la recherche. Les mesures actuelles figurent ci-dessus. Le tableau de septembre ci-dessous conserve les anciens essais Gemma sur S25 à titre historique.
Mesures du 27 septembre 2026. Les durées ci-dessous correspondent à un parcours RAG jusqu’à sa réponse contrôlée, avec les poids déjà téléchargés. Elles incluent la recherche et plusieurs passes du modèle ; ce ne sont pas des mesures du seul décodage.
| Appareil / candidat | Durée observée | Résultat du parcours |
|---|---|---|
| S25 Ultra · Samsung Internet · Gemma 4 E2B | 36,11 s | Question de prix : réponse complète, contrôlée, 1 500–5 000 € HT. |
| Ordinateur · Chrome / NVIDIA Ampere · Gemma 4 E2B | 12,25 s | Même question : 114 tokens ; le contrôle refuse aussi un brouillon au prix faux. |
| Même ordinateur · Nanbeige 4.2 Compact | 120,73 s | Réponse nominale correcte, 238 tokens ; acceptation erronée du brouillon faux lors du contre-test. |
| Même ordinateur · Gemma E2B · validation finale | 13,06 s | Test réel enregistré dans le CMS, puis activation du modèle commun aux deux profils. |
Les réponses ont des longueurs différentes et la reformulation peut changer les passages retrouvés : ces durées ne constituent pas un classement universel des modèles. Le contre-test présentait 15 000–100 000 € HT face à des sources indiquant 1 500–5 000 € HT. La réponse correcte de Nanbeige sur la question simple ne suffisait pas à qualifier son contrôle.
Sur cet ordinateur, Gemma E2B a aussi traité une objection de prix en 15,02 s et une question de maintenance en 12,99 s. Une fausse promesse « 24 heures pour 100 euros » et un chiffre d’affaires exact non publié ont mené à un relais humain en 25,91 s et 23,59 s. Ne pas inventer l’information faisait partie du test.
Les essais mobiles ont montré que des téléchargements plus petits ne garantissent pas une chaîne fiable : plusieurs candidats ont perdu le GPU, produit des répétitions ou échoué au contrôle. Les exports ONNX de Qwen 3.5 4B et Gemma 3 4B testés sur ordinateur n’ont pas donné de réponse finale dans ce parcours. Ces résultats concernent ces exports et moteurs, pas toutes les utilisations de ces modèles.
Les embeddings ont été mesurés séparément sur le S25, avec les poids en cache : Base, 4,275 s pour chargement, vérifications et première question, puis 90–103 ms ; Small, 3,487 s puis 24–27 ms. Le petit test de classement portait sur cinq passages, pas sur les 855 fragments du site. L’essentiel de la longue attente provenait des passes de réponse : remplacer l’embedding seul n’aurait pas résolu ce problème.
DONNÉES
L’inférence de réponse et la mémoire persistante s’exécutent sur l’appareil. Le service reste connecté : il télécharge des modèles et bibliothèques, envoie les vecteurs de recherche au serveur et reçoit les textes sources. Un embedding n’est pas une garantie d’anonymat. Les questions non couvertes peuvent être enregistrées côté CMS pour améliorer les connaissances, avec une conservation maximale de 90 jours sans nouvelle demande et une limite de 5 000 questions par site.
Les API appliquent le périmètre du site, les contrôles de session administrateur et les protections CSRF adaptées aux opérations. Les vecteurs reçus sont vérifiés : profil, nombre de dimensions, valeurs finies et normalisation. La recherche exclut les pages retirées et les formulaires non autorisés ; les brouillons de connaissances ne sont pas publiés dans les réponses.
Si la lecture de références web est activée, une URL publique fournie par le visiteur peut être lue par le serveur. Les protocoles, les adresses réseau et les redirections sont contrôlés pour bloquer l’accès aux réseaux privés. Le téléchargement est limité en volume et en durée. Le texte utile est extrait sans exécuter les scripts de la page ; il reste une référence externe, pas une nouvelle instruction système.
La référence peut aussi être la page publique ouverte : le client transmet son titre et son URL pour une question qui la désigne. Une URL explicite du visiteur est prioritaire. La lecture reste soumise aux mêmes protections serveur que les autres références web ; aucune adresse d’administration n’est utilisée comme page à résumer.
L’assistant peut aussi aider à préremplir un formulaire autorisé à partir des informations explicitement fournies par le visiteur. Le schéma des champs, la langue, le formulaire cible et la durée de validité sont contrôlés. Les valeurs déjà saisies sont préservées, le consentement n’est pas coché automatiquement et aucun formulaire n’est envoyé sans l’action de l’utilisateur.
MISE EN PRODUCTION
Le CMS ne se limite pas à choisir un nom de modèle. Il prépare les sources, reprend les passages à indexer, suit les extraits en attente et propose un test réel. Les profils de réponse mobile/tablette et ordinateur sont indépendants. La détection côté client utilise les informations du navigateur et de l’appareil ; réduire la largeur d’une fenêtre d’ordinateur ne la transforme pas en profil mobile.
Un changement de modèle, de consignes ou d’index remet en cause la validation concernée. Les sources modifiées doivent être préparées et leurs nouveaux extraits indexés, puis l’assistant peut être validé et réactivé. Le test réel est recommandé mais reste facultatif dans le CMS actuel. Les signatures de configuration empêchent de conserver une ancienne validation après un changement ; les réglages purement visuels la conservent.
La recette a couvert la génération réelle sur GPU, la cohérence numérique des embeddings, des questions de prix et de maintenance, des promesses fausses et des chiffres non publiés. Les corrections mobiles ont aussi été vérifiées avec clavier ouvert, lancement et fermeture de la fenêtre, bouton d’envoi accessible et absence de débordement. Les déploiements sauvegardent le périmètre concerné et contrôlent les pages publiques.
Les pistes restantes sont concrètes : élargir l’ensemble de questions de qualification, mesurer les téléchargements à froid et les quotas, vérifier davantage de couples navigateur/GPU, et comparer de nouveaux exports sur Adreno. Une application native pourrait accéder à d’autres accélérateurs ; un relais d’inférence hébergé pourrait alléger le téléphone. Ces pistes changeraient l’architecture et ne sont pas présentées ici comme déjà livrées.
Les choix et durées de cette étude proviennent des essais du projet. Ces documentations décrivent les technologies utilisées ; elles ne constituent pas des garanties de performance sur un appareil donné.
Le visiteur peut interroger les contenus et vérifier les sources. L’administrateur peut enrichir les connaissances, régler l’assistant et tester ses réponses. Le projet illustre toute la chaîne, de l’édition du contenu à son utilisation dans une conversation.
Découvrir l’expertise IA & RAG
Logiciels et produits métier
Un ERP métier qui relie affaires, planning sous contraintes, stocks, facturation et extranet client, avec ITS Report pour l’inspection vidéo.
Explorer le projet : Idea to Software
Sites internet professionnels
Un site industriel avec CMS sur mesure : contenus techniques, méthode C.A.R.E., références, franchise et parcours de demande de diagnostic.
Explorer le projet : RésilinerEt votre projet ?
Documentation, catalogue, procédures ou services : définissons les sources, les utilisateurs et les réponses attendues pour concevoir un assistant utile à votre activité.
Saisissez au moins 2 caractères pour lancer la recherche.