Procesando…
IA aplicada · RAG multimodal
Con EmbeddingGemma 2, Google acerca la búsqueda semántica a la ejecución local. Comparativa de arquitecturas RAG, tutorial de Python y límites reales de privacidad en tus dispositivos.
Una información importante puede estar escondida en un PDF, una captura de pantalla, un archivo de código o la grabación de una reunión. ¿Y si pudiéramos encontrar ese contenido con una simple pregunta, sin enviar los documentos a un servicio en la nube?
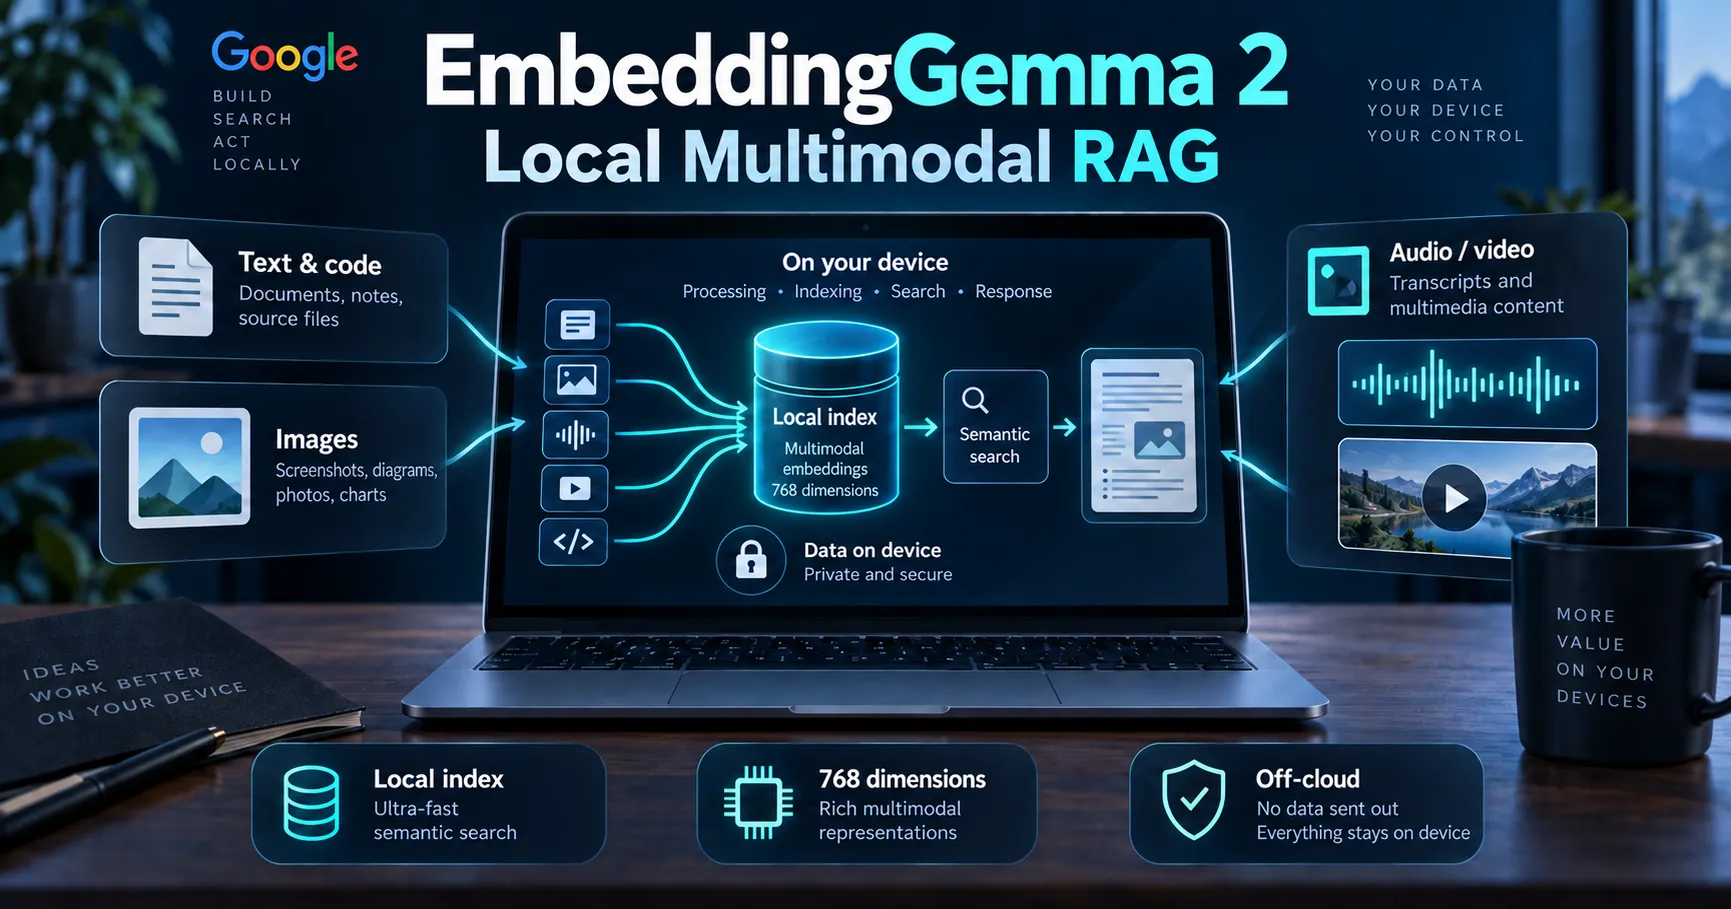
El 6 de octubre de 2026, Google DeepMind presentó EmbeddingGemma 2, un modelo de embeddings abierto, con licencia Apache 2.0, diseñado para buscar en varios formatos con una representación vectorial común. Su interés no se limita a su tamaño: hace más viable un motor de búsqueda semántica multimodal ejecutado localmente.
Este anuncio invita a analizar una etapa concreta del RAG: la indexación y la búsqueda semántica del conocimiento, antes de generar cualquier respuesta. ¿Qué formatos se pueden consultar con un mismo modelo? ¿Qué datos pueden permanecer en el dispositivo? ¿Y en qué situaciones aporta ventajas medibles frente a una API remota?
EmbeddingGemma 2 transforma texto, código, imágenes, vídeo y audio en vectores comparables de 768 dimensiones. Puede indexar y recuperar contenidos sin conexión una vez instalado. Sin embargo, no redacta respuestas: para generar texto hay que asociarlo a un LLM, local o remoto. La privacidad depende de todo el proceso.
En un sistema RAG (Retrieval-Augmented Generation), una aplicación divide las fuentes en fragmentos, crea sus embeddings, recupera los elementos más próximos a la pregunta y, si hace falta, se los proporciona a un modelo generativo. Esta búsqueda puede realizarse en una infraestructura remota, en un servidor privado o directamente en el dispositivo que contiene los archivos.
Cuando los datos son públicos y los comparten miles de usuarios, una API de embeddings centralizada suele ser una solución práctica. La decisión cambia cuando se trata de un contrato confidencial, un repositorio de software interno, notas de reuniones o capturas de pantalla de trabajo: no conviene que estos documentos circulen innecesariamente entre varios proveedores.
Por tanto, no hay que oponer sistemáticamente la nube y el entorno local. El mejor lugar para generar los embeddings depende de la sensibilidad de las fuentes, de su volumen y de los dispositivos que se vayan a utilizar realmente.
Basado en Gemma 4, el modelo proyecta texto, código, imágenes, fotogramas de vídeo y audio en un espacio de 768 dimensiones. Así, una consulta de texto se puede comparar con una imagen o un fragmento de audio: no es necesario pasar antes por una transcripción o una leyenda generada. Los distintos codificadores producen vectores compatibles entre sí.
La arquitectura es modular. No hace falta cargar los componentes dedicados al audio para crear un motor de búsqueda en un repositorio Git.
| Configuración | Parámetros | Uso adecuado |
|---|---|---|
| Texto y código | 270 M | Documentación, preguntas frecuentes, archivos fuente |
| Texto y visión | 440 M | Capturas, diagramas, fotos y fotogramas de vídeo |
| Texto y audio | 570 M | Grabaciones, sonidos y búsquedas por voz |
| Multimodal completo | 740 M | Búsqueda transversal en distintos tipos de contenido multimedia |
El contexto anunciado es de 8.192 tokens, compartidos entre las distintas modalidades. Para un documento o un vídeo largos, sigue siendo esencial seleccionar páginas, fragmentos o segmentos coherentes. Un embedding global de todo un corpus no sustituye a la indexación de sus contenidos.
El modelo de embeddings transforma una consulta y sus contenidos en representaciones numéricas. Permite clasificar resultados según su proximidad semántica. Un modelo generativo solo interviene si la aplicación debe resumir, explicar o responder con frases. Una búsqueda local acompañada de generación a través de una API remota no es un RAG completamente local.
Para decidir la arquitectura, conviene comparar tres situaciones en lugar de buscar «el mejor modelo» de forma abstracta.
La aplicación envía los contenidos a un proveedor para que los convierta en vectores. La puesta en marcha es rápida y el cálculo se delega. A cambio, hay que controlar los flujos de datos, los costes y la dependencia de la red.
El modelo de texto y el índice residen en el equipo. Suele ser la primera opción para notas, procedimientos o una base de código. El trabajo se centra en la extracción, la segmentación y la calidad de la recuperación.
Se añaden los codificadores necesarios para recuperar diagramas, capturas, audio o secuencias de vídeo. Resulta interesante cuando el texto ya no basta, pero hay que evaluar la indexación de los archivos multimedia y el consumo de memoria en el hardware de destino.
Los tres enfoques pueden compartir componentes: segmentación, filtros de negocio, metadatos y visualización de fuentes. Pasar al modo multimodal no obliga a reescribir toda la aplicación si el índice se ha diseñado correctamente.
Un modelo de embeddings no sustituye a la arquitectura documental. Para recuperar la información correcta y mostrar de dónde procede, hay que conservar las referencias a los archivos y gestionar los permisos desde el principio.
El último punto es importante: una puntuación de similitud alta no demuestra que el contenido sea exacto. Una interfaz profesional debe permitir abrir el documento de origen y, si corresponde, indicar que no se ha encontrado una respuesta suficientemente fiable.
Podemos empezar sin base de datos vectorial ni LLM. Este prototipo toma dos fragmentos breves, calcula sus embeddings con la configuración de texto y muestra el que más se aproxima a una pregunta. Ilustra la recuperación de contenido, no una aplicación RAG lista para producción.
Google documenta el uso de sentence-transformers a partir de la versión 6.1.0. La primera vez se descargan los pesos del modelo; después es posible ejecutarlo localmente sin conexión, siempre que los archivos necesarios estén en la caché.
python -m venv .venv
source .venv/bin/activate  # Linux o macOS
# En Windows: .venv\Scripts\activate
pip install -U "sentence-transformers[image,audio,video]" transformersfrom sentence_transformers import SentenceTransformer
model = SentenceTransformer(
"google/embeddinggemma-2",
config_kwargs={"vision_config": None, "audio_config": None},
)
documents = [
"Una aplicación controla los permisos de acceso a los documentos.",
"El acta describe una arquitectura de búsqueda local.",
]
question = "¿Dónde encontrar las decisiones sobre la búsqueda sin conexión?"
vectors = model.encode(
documents,
prompt_name="Document",
normalize_embeddings=True,
)
query_vector = model.encode(
question,
prompt_name="SearchQuery",
normalize_embeddings=True,
)
scores = model.similarity(query_vector, vectors)[0]
best_index = int(scores.argmax())
print(documents[best_index])
print("Puntuación:", float(scores[best_index]))Los prompts Document y SearchQuery son los que aparecen en la guía de Google. El resultado es un fragmento clasificado, no una respuesta redactada. En una versión para uso profesional, también conservaría los identificadores de los archivos, sus URL locales o rutas autorizadas y los metadatos necesarios para citar el fragmento correcto.
Para la búsqueda multimodal, se cargan los codificadores necesarios y se pasa el contenido multimedia al modelo en forma de objeto que describe su modalidad. El siguiente ejemplo corresponde a la API que presenta la guía para desarrolladores:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

image_vector = model.encode({"image": "captura-interfaz.png"})
audio_vector = model.encode({"audio": "fragmento-reunion.wav"})
query_vector = model.encode(
    "debate sobre la arquitectura de la aplicación",
    prompt_name="SearchQuery",
)

print("Imagen:", model.similarity(query_vector, image_vector))
print("Audio:", model.similarity(query_vector, audio_vector))
Los archivos deben estar disponibles localmente y ser compatibles con el entorno de ejecución. Para vídeo, la guía indica que se admiten archivos MP4 con un muestreo de un fotograma por segundo de forma predeterminada. El audio debe prepararse, en particular, en mono a 16 kHz.
Una captura se puede indexar mediante visión. Un PDF técnico suele requerir un tratamiento mixto: texto extraíble, diagramas y, si hace falta, OCR para las páginas escaneadas.
Para recuperar un momento concreto, hay que indexar segmentos con sus marcas de tiempo. Una única representación para todo un vídeo no garantiza una localización temporal útil.
Las transcripciones y los subtítulos siguen siendo útiles. Pueden facilitar la accesibilidad, las auditorías, el filtrado por palabras exactas y la cita de lo que realmente dijo una persona.
Google anuncia unos 191 MB de RAM activa solo para texto y 567 MB para el modo multimodal completo en un Pixel 11 Pro. Estas cifras proceden de configuraciones optimizadas en un dispositivo concreto: no representan ni un pico de memoria universal ni el coste total de un proceso con Python o web. Hay que añadir el entorno de ejecución, los archivos multimedia, las activaciones, el índice y, si corresponde, el LLM.
EmbeddingGemma 2 también utiliza el principio Matryoshka Representation Learning (MRL), que permite truncar los vectores de 768 dimensiones a 512, 256 o 128. Esta elección afecta sobre todo al espacio ocupado por los embeddings; su efecto en la recuperación debe medirse con los datos del proyecto.
Un millón de vectores float32 ocupa aproximadamente 3,07 GB de datos sin procesar, sin contar los metadatos ni la estructura del índice.
El mismo millón de vectores float32 ocupa aproximadamente 1,02 GB: tres veces menos, con un equilibrio de calidad que hay que comprobar.
Google indica que, con 256 dimensiones, sus evaluaciones conservan alrededor del 95 % de la calidad de referencia en búsqueda de imágenes, vídeo y voz. Este resultado no está garantizado para todos los corpus. La llamada model.encode(..., truncate_dim=256, normalize_embeddings=True) permite probar esta configuración; las consultas y los documentos deben utilizar la misma dimensión.
Los pesos del modelo y las integraciones se ofrecen en varios entornos, entre ellos Transformers, sentence-transformers, MLX, Ollama y LiteRT. Google también muestra dos demostraciones ya anunciadas en AI Edge Gallery: Instant Media Search y Video Moments Finder. La primera utiliza, entre otras cosas, un índice SQLite local y una clasificación por similitud coseno.
Para Mac, Google también presenta AI Edge Foresight, un asistente experimental para reuniones que combina notas, conversaciones y archivos privados con procesamiento local. En un proyecto profesional, estos ejemplos sirven como referencias de arquitectura; no garantizan que una integración con el navegador esté lista para usarse sin adaptaciones.
Google anuncia que EmbeddingGemma 2 llegará a ML Kit para Android en las semanas posteriores al 6 de octubre. La empresa también menciona la compatibilidad multiplataforma mediante MediaPipe para iOS, macOS, Windows, Linux y Web. A 7 de octubre de 2026, hay que comprobar las versiones publicadas y los requisitos de CPU, GPU o Web antes de prometer una ejecución idéntica en todas partes.
Para una integración web, el diseño debe tener en cuenta el tamaño de la descarga inicial, la caché de los pesos, los límites de memoria de una pestaña, el almacenamiento local del índice y los navegadores compatibles. Un prototipo que funciona en un equipo de gama alta no es automáticamente adecuado para todos los teléfonos inteligentes.
Trasladar los embeddings al dispositivo elimina algunas transferencias, pero no basta para garantizar la privacidad. Los propios vectores pueden revelar información sobre sus fuentes, y un componente generativo remoto puede volver a introducir un intercambio de datos por la red.
El entorno local es una propiedad de la arquitectura que hay que verificar: abarca la ingesta, los embeddings, el índice, la búsqueda y la posible generación, no solo el nombre del modelo.
Para comparar estas arquitecturas, se puede preparar un corpus de pruebas autorizado y representativo con documentación técnica, archivos fuente, capturas de pantalla y fragmentos de audio. El objetivo no es demostrar que la ejecución local sea siempre superior, sino identificar qué volúmenes, dispositivos y requisitos de privacidad justifican esta elección. El siguiente protocolo es una propuesta metodológica, no el resultado de pruebas ya realizadas.
Preparar archivos representativos, metadatos y entre 30 y 50 preguntas con respuestas esperadas conocidas.
Evaluar una API remota, una búsqueda de texto local y una búsqueda multimodal con los mismos datos y el mismo hardware.
Registrar recall@k, calidad de las fuentes, latencia, tiempo de indexación, memoria y tamaño del índice, primero con 768 y luego con 256 dimensiones.
Añadir generación local solo si la experiencia de usuario requiere una respuesta redactada y probar que el sistema se abstenga cuando no haya fuentes.
Un posible escenario de evaluación consiste en indexar un corpus documental de demostración que incluya código, diagramas y fragmentos de reuniones, y comprobar que cada resultado conduce al archivo, pasaje o instante correcto. Las mediciones obtenidas permitirían determinar si un índice multimodal local aporta ventajas reales frente a otras arquitecturas. Este escenario no describe un producto ya desplegado.
Encuentra respuestas a las principales preguntas sobre la ejecución local, los modelos y los entornos compatibles.
Sí, para la codificación y la búsqueda, una vez instalados los pesos y las dependencias necesarias. Esto no hace que el resto de la aplicación funcione automáticamente sin conexión.
No. Clasifica contenidos según su proximidad semántica. Para redactar una respuesta hace falta un LLM adicional, local si se quiere mantener la generación en el dispositivo.
No. Los codificadores son modulares. Una búsqueda documental de texto y código puede utilizar la configuración de 270 millones de parámetros.
No necesariamente. Facilita la distribución, pero sus limitaciones de memoria, compatibilidad y caché pueden hacer que una aplicación de escritorio o móvil sea más adecuada para algunos usos.
Artículo redactado a partir de los anuncios publicados el 6 de octubre de 2026. Las cifras de hardware proceden de los datos publicados por Google; no se han realizado pruebas de rendimiento independientes para este artículo. Los ejemplos de Python ilustran las API documentadas y deben adaptarse al hardware, las dependencias y los archivos utilizados en las pruebas.
La idea clave: EmbeddingGemma 2 no resuelve por sí solo las cuestiones de calidad documental, permisos o seguridad. Sin embargo, ofrece un componente interesante para crear búsquedas de texto, imágenes y audio cerca de los usuarios, sin imponer una API remota en cada consulta. Es una opción que hay que evaluar, no una promesa universal.
IA APLICADA
La visión artificial, YOLO y RAG resultan útiles cuando se conectan con tus datos, equipos y limitaciones reales.
Introduce al menos 2 caracteres para iniciar la búsqueda.