Traitement en cours…
IA appliquée · RAG multimodal
Avec EmbeddingGemma 2, Google rapproche recherche sémantique et exécution locale. Comparaison des architectures RAG, tutoriel Python et limites réelles de confidentialité sur vos appareils.
Une information importante peut se cacher dans un PDF, une capture d’écran, un fichier de code ou l’enregistrement d’une réunion. Et si l’on pouvait retrouver ce contenu par une simple question, sans envoyer les documents à un service cloud ?
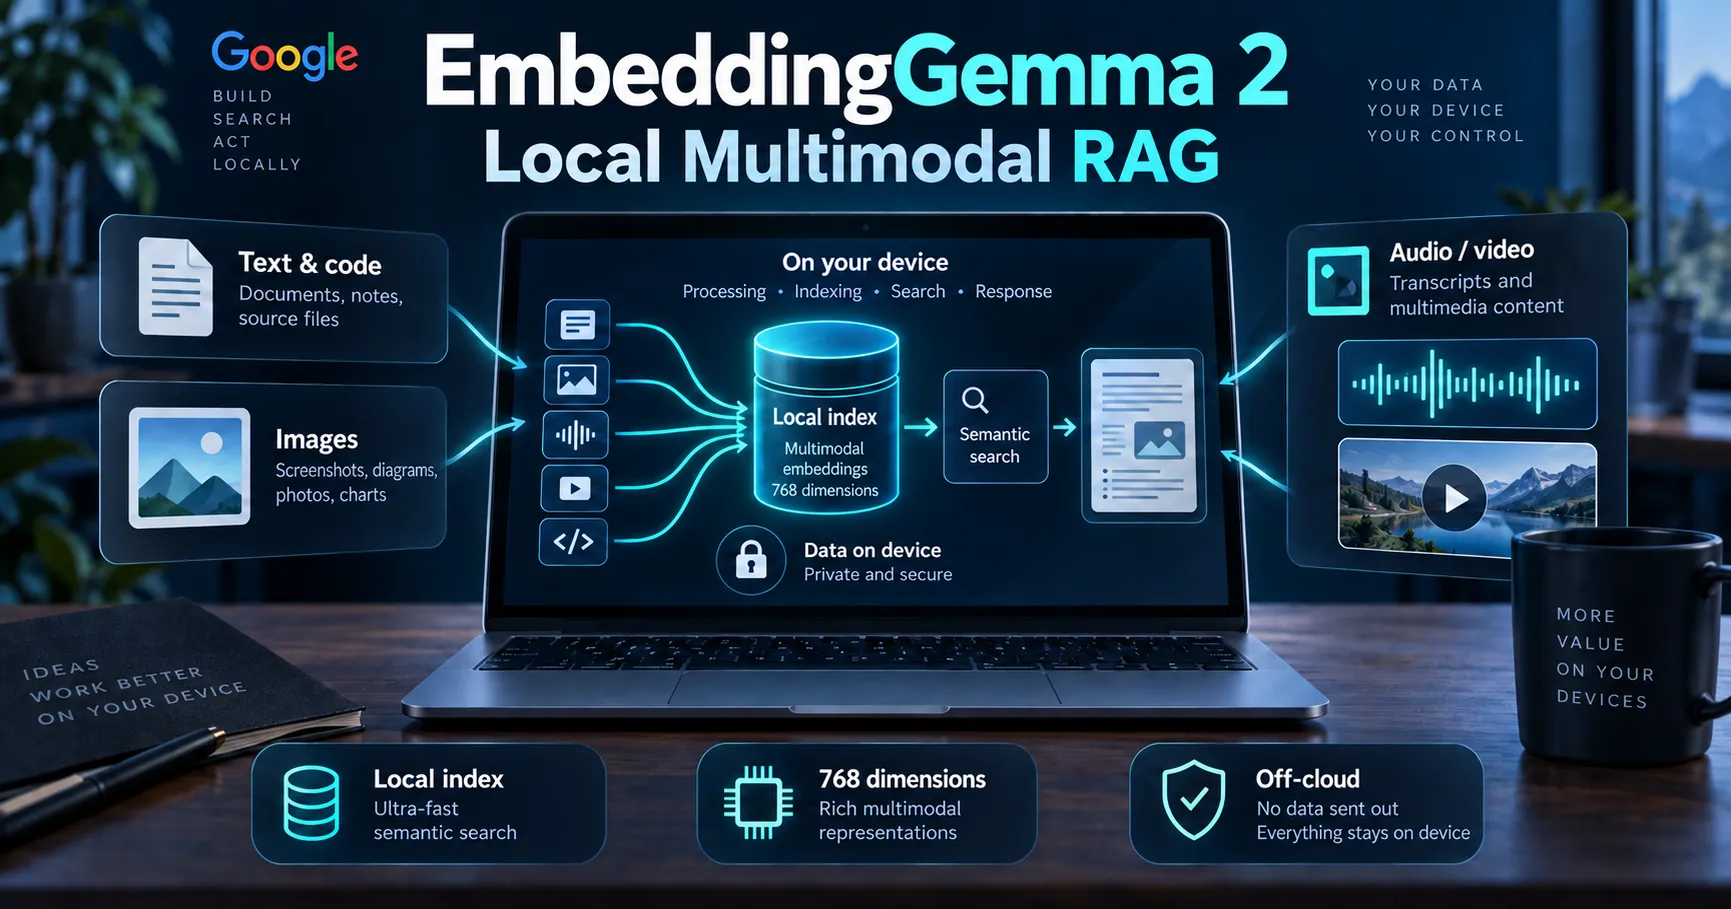
Le 6 octobre 2026, Google DeepMind a présenté EmbeddingGemma 2, un modèle d’embeddings ouvert, sous licence Apache 2.0, conçu pour rechercher dans plusieurs formats avec une représentation vectorielle commune. Son intérêt ne se limite pas à sa taille : il rend plus crédible un moteur de recherche sémantique multimodal exécuté localement.
Cette annonce invite à examiner une étape précise du RAG : l’indexation et la recherche sémantique des connaissances, avant toute génération de réponse. Quels formats peut-on interroger avec un même modèle ? Quelles données peuvent rester sur l’appareil ? Et dans quels cas cette approche offre-t-elle un avantage concret face à une API distante ?
EmbeddingGemma 2 transforme texte, code, images, vidéo et audio en vecteurs comparables de 768 dimensions. Il peut indexer et retrouver des contenus hors connexion une fois installé. En revanche, il ne rédige pas de réponse : pour générer du texte, il faut lui associer un LLM, local ou distant. La confidentialité dépend de l’ensemble du pipeline.
Dans un système RAG (Retrieval-Augmented Generation), une application découpe les sources en passages, crée leurs embeddings, retrouve les éléments proches de la question et les fournit éventuellement à un modèle génératif. Cette recherche peut s’effectuer dans une infrastructure distante, sur un serveur privé, ou directement sur l’appareil qui possède les fichiers.
Lorsque les données sont publiques et partagées par des milliers d’utilisateurs, une API d’embeddings centralisée reste souvent une solution pragmatique. Le choix change pour un contrat confidentiel, un dépôt logiciel interne, des notes de réunion ou des captures d’écran métier : ces documents ne devraient pas circuler inutilement entre plusieurs prestataires.
Il ne faut donc pas opposer systématiquement cloud et local. Le meilleur emplacement pour les embeddings dépend de la sensibilité des sources, de leur volume et des appareils réellement utilisés.
Basé sur Gemma 4, le modèle projette texte, code, images, images vidéo et audio dans un espace de 768 dimensions. Une requête textuelle peut ainsi être comparée à une image ou à un extrait sonore : elle n’a pas nécessairement besoin de passer par une transcription ou une légende générée au préalable. Les différents encodeurs produisent des vecteurs compatibles entre eux.
L’architecture est modulaire. Il n’est pas nécessaire de charger les composants dédiés à l’audio pour créer un moteur de recherche dans un dépôt Git.
| Configuration | Paramètres | Usage pertinent |
|---|---|---|
| Texte et code | 270 M | Documentation, FAQ, fichiers source |
| Texte et vision | 440 M | Captures, schémas, photos et images vidéo |
| Texte et audio | 570 M | Enregistrements, sons et recherches par la parole |
| Multimodal complet | 740 M | Recherche transverse dans les différents médias |
Le contexte annoncé est de 8 192 tokens, partagé entre les modalités. Pour un document ou une vidéo longue, il reste essentiel de sélectionner des pages, passages ou segments cohérents. Un embedding global de tout un corpus n’est pas un substitut à l’indexation de ses contenus.
Le modèle d’embeddings transforme une requête et des contenus en représentations numériques. Il permet de classer des résultats par proximité sémantique. Un modèle génératif intervient seulement si l’application doit résumer, expliquer ou répondre en phrases. Une recherche locale accompagnée d’une génération par API distante n’est pas un RAG entièrement local.
Pour décider de l’architecture, trois situations méritent d’être comparées plutôt que de rechercher « le meilleur modèle » de manière abstraite.
L’application transmet les contenus à un prestataire pour les vectoriser. La mise en route est rapide et le calcul est déporté. En contrepartie, il faut maîtriser les flux de données, les coûts et la dépendance réseau.
Le modèle de texte et l’index résident sur le poste. C’est souvent le premier choix pour des notes, des procédures ou une base de code. Le travail se concentre sur l’extraction, le découpage et la qualité du rappel.
On ajoute les encodeurs utiles pour retrouver schémas, captures, audio ou séquences vidéo. C’est intéressant lorsque le texte seul ne suffit plus, mais l’indexation des médias et la consommation mémoire doivent être évaluées sur le matériel cible.
Les trois approches peuvent partager des briques : segmentation, filtres métier, métadonnées et affichage des sources. Le passage au multimodal n’oblige pas à réécrire toute l’application si l’index a été conçu proprement.
Un modèle d’embeddings ne remplace pas l’architecture documentaire. Pour retrouver la bonne information et montrer d’où elle vient, il faut conserver les références aux fichiers et gérer les permissions dès le départ.
Le dernier point est important : un score de similarité élevé n’est pas une preuve que le contenu est exact. Une interface professionnelle doit permettre d’ouvrir le document d’origine et de constater, le cas échéant, qu’aucune réponse suffisamment fiable n’a été trouvée.
On peut commencer sans base vectorielle ni LLM. Ce prototype prend deux courts passages, calcule leurs embeddings avec la configuration texte et affiche celui qui se rapproche le plus d’une question. Il illustre la récupération de contenu, pas une application RAG prête pour la production.
Google documente l’utilisation de sentence-transformers à partir de la version 6.1.0. La première utilisation télécharge les poids du modèle ; l’exécution locale hors connexion est possible ensuite, si les fichiers nécessaires sont bien en cache.
python -m venv .venv
source .venv/bin/activate  # Linux ou macOS
# Sous Windows : .venv\Scripts\activate
pip install -U "sentence-transformers[image,audio,video]" transformersfrom sentence_transformers import SentenceTransformer
model = SentenceTransformer(
"google/embeddinggemma-2",
config_kwargs={"vision_config": None, "audio_config": None},
)
documents = [
"Une application contrôle les droits d’accès aux documents.",
"Le compte rendu décrit une architecture de recherche locale.",
]
question = "Où retrouver les décisions sur la recherche hors ligne ?"
vectors = model.encode(
documents,
prompt_name="Document",
normalize_embeddings=True,
)
query_vector = model.encode(
question,
prompt_name="SearchQuery",
normalize_embeddings=True,
)
scores = model.similarity(query_vector, vectors)[0]
best_index = int(scores.argmax())
print(documents[best_index])
print("Score :", float(scores[best_index]))Les prompts Document et SearchQuery sont ceux du guide Google. Le résultat est un passage classé, pas une réponse rédigée. Dans une version métier, je conserverais également les identifiants des fichiers, leurs URLs locales ou chemins autorisés et les métadonnées indispensables pour citer le bon extrait.
Pour la recherche multimodale, on charge les encodeurs utiles puis on passe le média au modèle sous forme d’objet décrivant sa modalité. L’exemple suivant correspond à l’API présentée dans le guide développeur :
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

image_vector = model.encode({"image": "capture-interface.png"})
audio_vector = model.encode({"audio": "extrait-reunion.wav"})
query_vector = model.encode(
    "discussion sur l'architecture de l'application",
    prompt_name="SearchQuery",
)

print("Image :", model.similarity(query_vector, image_vector))
print("Audio :", model.similarity(query_vector, audio_vector))
Les fichiers doivent être présents localement et compatibles avec le runtime. Pour la vidéo, le guide indique une prise en charge MP4 avec un échantillonnage des images à une image par seconde par défaut. L’audio doit notamment être préparé en mono 16 kHz.
Une capture peut être indexée par la vision. Un PDF technique réclame souvent un traitement mixte : texte extractible, schémas et éventuellement OCR pour les pages scannées.
Pour retrouver un instant précis, indexer des segments avec leurs horodatages. Une seule représentation pour toute une vidéo ne garantit pas une localisation temporelle exploitable.
Les transcriptions et légendes ne deviennent pas inutiles. Elles peuvent faciliter l’accessibilité, l’audit, le filtrage de mots exacts et la citation de ce que la personne a réellement dit.
Google annonce environ 191 Mo de RAM active en texte seul et 567 Mo pour le multimodal complet sur Pixel 11 Pro. Ces chiffres proviennent de configurations optimisées sur un appareil précis : ils ne représentent ni le pic mémoire universel, ni le coût total d’un pipeline Python ou Web. Il faut ajouter le runtime, les médias, les activations, l’index et éventuellement le LLM.
EmbeddingGemma 2 utilise aussi le principe Matryoshka Representation Learning (MRL), permettant de tronquer les vecteurs de 768 dimensions à 512, 256 ou 128. Ce choix agit surtout sur l’espace occupé par les embeddings ; son effet sur le rappel doit être mesuré sur les données du projet.
Un million de vecteurs float32 représente environ 3,07 Go de données brutes, hors métadonnées et structure de l’index.
Le même million de vecteurs float32 occupe environ 1,02 Go : trois fois moins, avec un compromis de qualité à vérifier.
Google indique qu’à 256 dimensions, ses évaluations conservent environ 95 % de la qualité de référence en recherche image, vidéo et parole. Ce n’est pas un résultat garanti pour tous les corpus. L’appel model.encode(..., truncate_dim=256, normalize_embeddings=True) permet de tester cette configuration ; requêtes et documents doivent utiliser la même dimension.
Les poids du modèle et des intégrations sont proposés dans plusieurs environnements, dont Transformers, sentence-transformers, MLX, Ollama et LiteRT. Google montre également deux démonstrations déjà annoncées dans AI Edge Gallery : Instant Media Search et Video Moments Finder. La première utilise notamment un index SQLite local et un classement par similarité cosinus.
Sur Mac, Google présente aussi AI Edge Foresight, un compagnon de réunion expérimental qui associe notes, conversations et fichiers privés avec du traitement local. Pour un projet métier, ces exemples constituent des références d’architecture, pas la promesse qu’une intégration navigateur est prête sans adaptation.
Google annonce l’arrivée d’EmbeddingGemma 2 dans ML Kit sur Android dans les semaines suivant le 6 octobre. L’entreprise évoque également le support cross-platform via MediaPipe pour iOS, macOS, Windows, Linux et Web. Au 7 octobre 2026, il faut vérifier les versions livrées et les contraintes CPU, GPU ou Web avant de promettre une exécution identique partout.
Pour une intégration Web, la conception doit prévoir la taille du téléchargement initial, le cache des poids, les limites mémoire d’un onglet, le stockage local de l’index et les navigateurs compatibles. Un prototype qui fonctionne sur un poste haut de gamme n’est pas automatiquement adapté à tous les smartphones.
Déplacer les embeddings sur l’appareil élimine certains transferts, mais ne suffit pas à garantir la confidentialité. Les vecteurs eux-mêmes peuvent révéler des informations sur leurs sources, et un composant de génération distant peut réintroduire un échange réseau.
Le local est une propriété d’architecture à vérifier : elle porte sur l’ingestion, les embeddings, l’index, la recherche et la génération éventuelle, pas seulement sur le nom du modèle.
Pour comparer ces architectures, on peut préparer un corpus de test autorisé et représentatif : documentation technique, fichiers source, captures d’écran et extraits audio. L’objectif n’est pas de démontrer que le local est toujours supérieur, mais d’identifier les volumes, les appareils et les contraintes de confidentialité qui rendent ce choix pertinent. Le protocole ci-dessous est une proposition méthodologique, et non le compte rendu de tests déjà réalisés.
Préparer des fichiers représentatifs, les métadonnées et 30 à 50 questions dont les réponses attendues sont connues.
Évaluer API distante, recherche texte locale et recherche multimodale sur les mêmes données et le même matériel.
Suivre recall@k, qualité des sources, latence, temps d’indexation, mémoire et taille de l’index, à 768 puis 256 dimensions.
Ajouter une génération locale uniquement si l’expérience utilisateur a besoin d’une réponse rédigée, et tester les refus en absence de sources.
Un scénario d’évaluation possible consiste à indexer un corpus documentaire de démonstration associant code, schémas et extraits de réunion, puis à vérifier que chaque résultat renvoie au bon fichier, passage ou horodatage. Les mesures obtenues permettraient de décider si un index multimodal local apporte une réelle valeur par rapport aux autres architectures. Ce scénario ne décrit pas un produit déjà déployé.
Retrouvez les réponses aux principales questions sur l’exécution locale, les modèles et les environnements compatibles.
Oui pour l’encodage et la recherche, après installation des poids et des dépendances nécessaires. Cela ne rend pas automatiquement hors ligne le reste de l’application.
Non. Il classe des contenus par proximité sémantique. La rédaction d’une réponse demande un LLM supplémentaire, local si l’on souhaite garder la génération sur l’appareil.
Non. Les encodeurs sont modulaires. Une recherche documentaire texte et code peut utiliser la configuration à 270 millions de paramètres.
Pas nécessairement. Il offre une distribution pratique, mais ses contraintes de mémoire, de compatibilité et de cache peuvent rendre une application desktop ou mobile plus adaptée à certains usages.
Article rédigé sur la base des annonces publiées le 6 octobre 2026. Les chiffres matériels sont ceux annoncés par Google ; aucun benchmark indépendant n’a été réalisé pour cet article. Les exemples Python illustrent les API documentées et doivent être adaptés au matériel, aux dépendances et aux fichiers testés.
Le point essentiel : EmbeddingGemma 2 ne règle pas à lui seul les questions de qualité documentaire, de permissions ou de sécurité. Il apporte en revanche une brique intéressante pour construire des recherches texte, image et audio exécutées près des utilisateurs, sans imposer une API distante à chaque requête. C’est une piste à mesurer, pas une promesse universelle.
IA APPLIQUÉE
Vision, YOLO ou RAG deviennent utiles lorsqu’ils s’intègrent aux données, aux équipes et aux contraintes réelles de l’entreprise.
Saisissez au moins 2 caractères pour lancer la recherche.