RAG y WebGPU: cuando tu sitio se convierte en un asistente de IA
He desarrollado un asistente que busca en los conocimientos de mi sitio y genera sus respuestas en el navegador. Un repaso a esta primera versión: ventajas, límites y posibles aplicaciones.
Tu sitio ya contiene las respuestas. Solo falta que tus visitantes las encuentren. ¿Y si pudieran explicar simplemente lo que buscan?
«¿Cuánto cuesta un sitio web informativo?», «¿Qué incluye el mantenimiento?», «¿Se adapta a mi proyecto?»: estas preguntas abarcan varias páginas, secciones o preguntas frecuentes. Como desarrollador freelance, he diseñado y publicado una primera versión de un asistente de IA RAG que se apoya en los contenidos de SDX Development y genera sus respuestas en el navegador gracias a WebGPU.
El resultado abre posibilidades más allá de mi propio sitio: ayudar a encontrar una vivienda, elegir un producto técnico, descubrir una formación o consultar documentación. Pero este enfoque también tiene límites concretos. Esto es lo que permite hoy, lo que exige del dispositivo del visitante y las aplicaciones que aún queda por desarrollar.
RAG y WebGPU: los conocimientos del sitio, el procesamiento del navegador
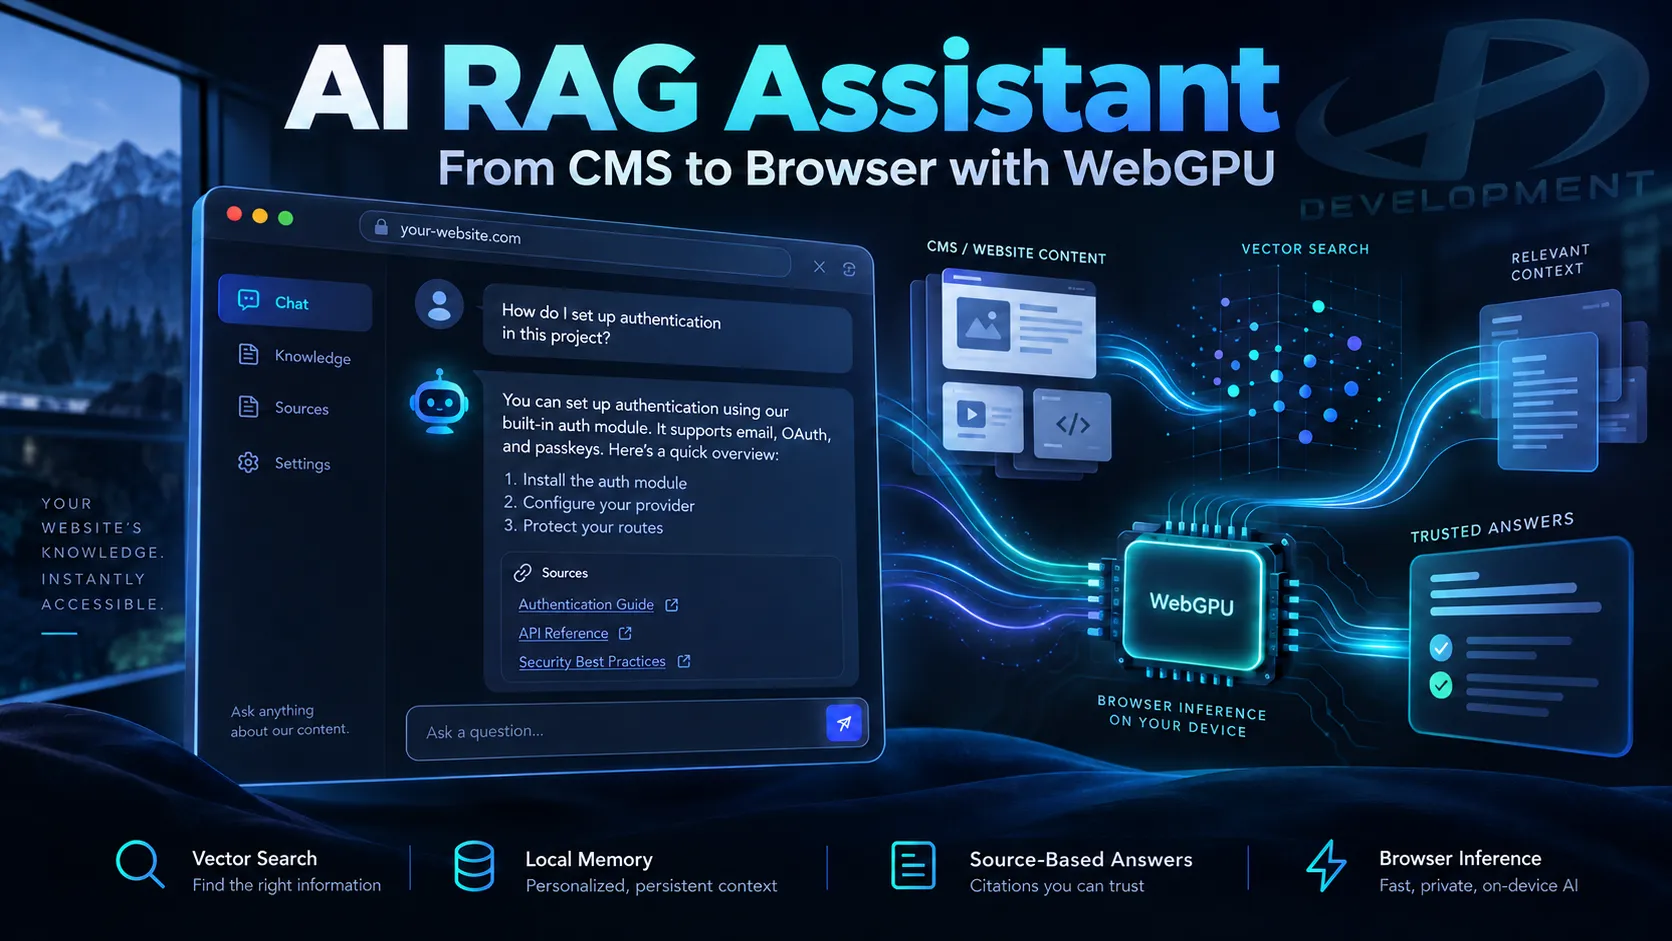
RAG, siglas de Retrieval-Augmented Generation, consiste en buscar información pertinente antes de pedir al modelo que redacte una respuesta. En lugar de depender únicamente de lo que la IA aprendió durante su entrenamiento, se le proporcionan fragmentos de documentos seleccionados para la pregunta planteada.
WebGPU permite que una aplicación web utilice el procesador gráfico del dispositivo para realizar cálculos. En este sistema, sirve para ejecutar el modelo de respuesta y el modelo de embeddings: este último transforma una pregunta en un vector numérico para buscar contenidos semánticamente similares.
Preparar los conocimientos. El CMS divide los documentos en fragmentos, calcula su representación y crea el índice antes de las conversaciones.
Entender la pregunta. El navegador utiliza el contexto reciente, puede reformular una pregunta de seguimiento y calcula el vector de búsqueda.
Recuperar los fragmentos útiles. El servidor consulta el índice y devuelve fragmentos autorizados para el sitio y el idioma correspondientes.
Redactar y revisar. El modelo local prepara una respuesta y, después, realiza una etapa de control antes de mostrarla. Si falta información, el asistente debe indicarlo.
Mostrar la respuesta y sus fuentes. El visitante puede consultar las páginas utilizadas y continuar con su pregunta.
El navegador y el servidor tienen, por tanto, funciones distintas. Hay que descargar los archivos de los modelos y la búsqueda documental sigue conectada al servidor. No es un asistente completamente desconectado. La descripción detallada de los componentes, los controles y los intercambios de datos está disponible en mi caso práctico técnico del asistente de IA RAG.
Lo que ya hace la versión de SDX
En mi sitio, el asistente ayuda a consultar los servicios, las tarifas y la información práctica. Los conocimientos se gestionan desde el CMS: documentos, indexación, modelos, comportamiento del asistente y validación antes de activarlo.
La memoria local es opcional. Conserva hasta 60 intercambios durante 7 días en el navegador utilizado y ofrece una opción para borrarlos. Permite retomar una conversación y entender una pregunta como «¿Y el mantenimiento?» después de haber hablado de un sitio web informativo.
Esta memoria no vuelve a entrenar el modelo. Una respuesta antigua no sustituye a los documentos actuales como fuente de información. La reformulación sirve para recuperar el tema de la pregunta; después, la búsqueda vuelve a consultar los conocimientos.
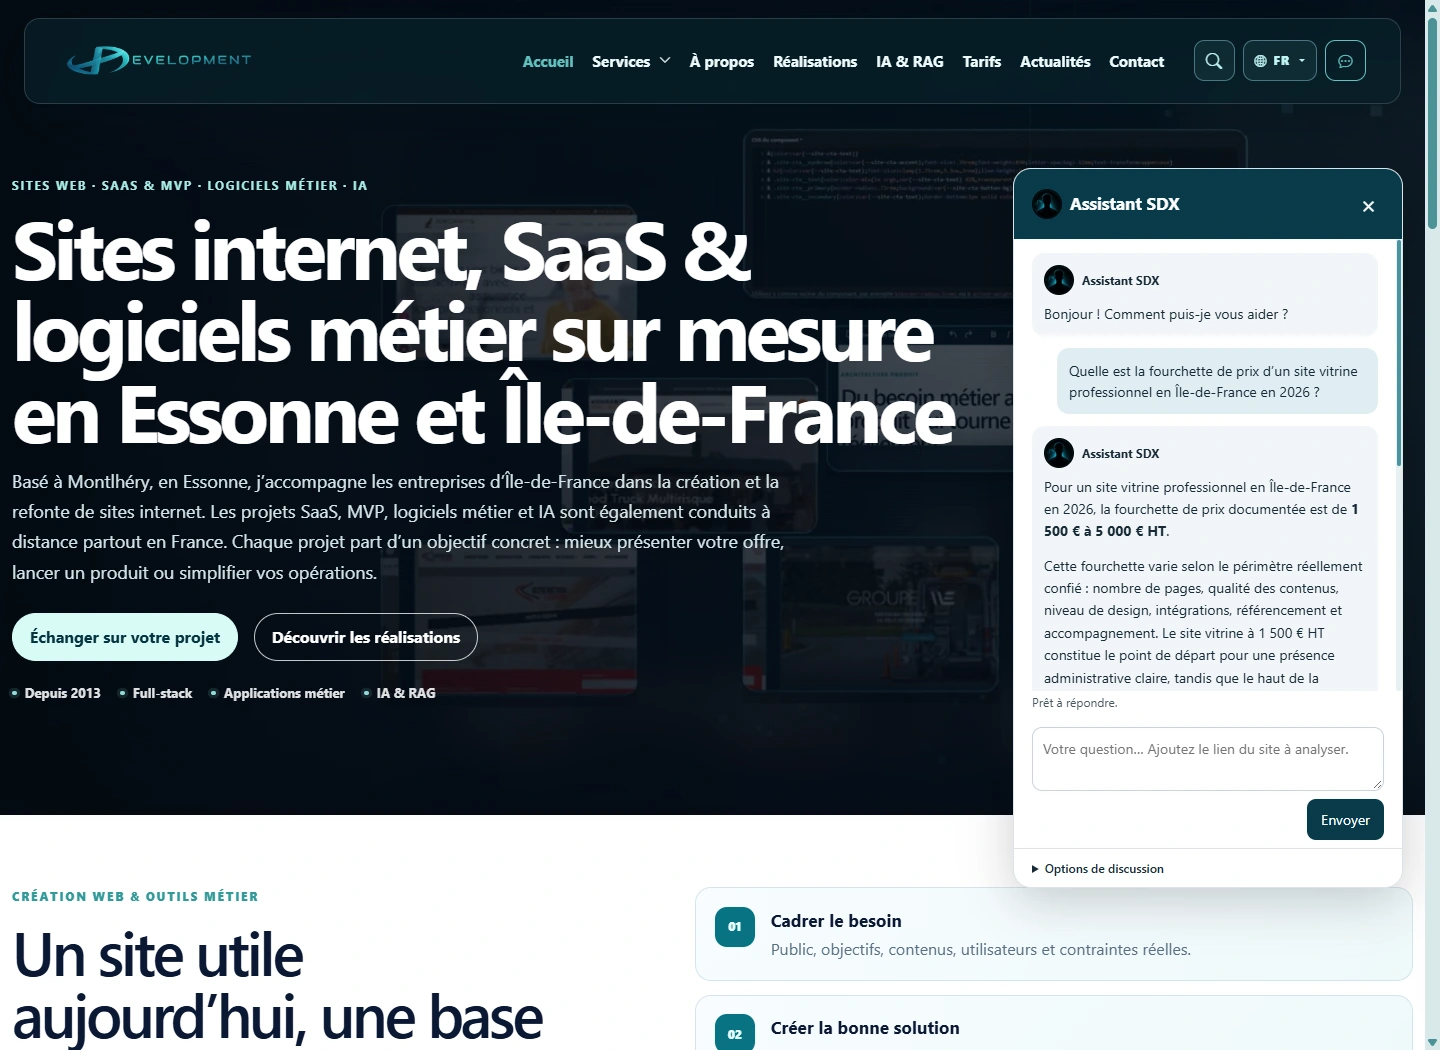
Captura real de una de mis pruebas durante el desarrollo. Muestra la interfaz y las fuentes; el modelo de respuesta ha evolucionado desde que se tomó.
También he adaptado la interfaz para Android: ventana que ocupa la altura visible, área de texto más compacta, botón de envío accesible con el teclado abierto y lanzador oculto durante la conversación. La pantalla puede permanecer encendida durante el chat cuando el navegador permite esta función.
Cuando el recorrido lo prevé, el asistente puede preparar el formulario con la información proporcionada explícitamente. El visitante mantiene el control: no se marca ninguna casilla de consentimiento ni se envía ningún formulario automáticamente.
Inmobiliaria: pasar de los criterios a una selección explicada
El sector inmobiliario es una aplicación especialmente interesante. No siempre se piensa en filtros: el visitante explica un proyecto de vida, sus limitaciones y sus preferencias.
«Busco un piso de tres habitaciones con balcón, cerca del transporte público y por menos de 300 000 €. Trabajo mucho desde casa. ¿Qué viviendas podrían encajar conmigo?»
Un asistente podría preguntar por la zona deseada, distinguir los criterios imprescindibles de las preferencias y, después, proponer una selección razonada: por qué encaja cada vivienda, qué compromiso implica y dónde consultar el anuncio original. Una pregunta de seguimiento como «Mejor en una zona tranquila y con despacho» serviría para afinar la búsqueda.
El lenguaje natural debe apoyarse en un catálogo fiable
El precio, la superficie, el número de habitaciones y la disponibilidad deben filtrarse a partir de los datos estructurados de la inmobiliaria. La búsqueda semántica puede ayudar después a relacionar las descripciones con las preferencias expresadas. Pedirle únicamente a un modelo que «encuentre una vivienda» en unos textos podría dar lugar a recomendaciones que superen el presupuesto o a viviendas ya vendidas.
Por tanto, una integración seria conectaría el asistente con el catálogo actualizado, las reglas de búsqueda y las fichas de las viviendas. Los tiempos de desplazamiento, los servicios del barrio o la disponibilidad de visitas requerirían sus propias fuentes fiables. La IA no debe inventarlos.
La ventaja sería hacer más comprensible la búsqueda: presentar unas cuantas viviendas y explicar por qué encajan, en lugar de dejar que el visitante recorra por su cuenta una lista larga. Después, se podría preparar una solicitud de visita para que el visitante la confirme y la envíe.
Otras cuatro aplicaciones por explorar
Los escenarios siguientes son posibles adaptaciones, no implementaciones ya realizadas para clientes. Todos tienen algo en común: una pregunta concreta y datos verificables para responderla.
01
Un catálogo de productos técnicos
Ayudar a comparar equipos según una necesidad y sus características documentadas. La compatibilidad, los precios y las existencias seguirían controlándose con los datos del catálogo, con la intervención de una persona para las decisiones delicadas.
02
Un sitio de turismo o alojamiento
Orientar hacia una estancia, un alojamiento o una actividad según las preferencias. La disponibilidad y las tarifas procederían del sistema de reservas; el RAG serviría para explicar los servicios y las condiciones.
03
Un centro de formación
Relacionar un objetivo profesional con los programas, los requisitos previos y los perfiles destinatarios. El asistente podría explicar las diferencias y preparar una solicitud de asesoramiento, sin garantizar la admisión ni la financiación.
04
La documentación de un software profesional
Encontrar un procedimiento, aclarar una función o guiar a un usuario en una tarea. Los documentos privados exigirían autenticación y permisos de búsqueda adecuados: mi demostración actual utiliza información pública.
Las ventajas: otra forma de acceder a tus contenidos
Para el visitante
Expresar sus necesidades con sus propias palabras
El diálogo puede relacionar varias páginas y tener en cuenta las precisiones sucesivas. El visitante no necesita conocer el vocabulario del sitio ni la ubicación exacta de la información.
Para los conocimientos
Responder con referencias consultables
Los fragmentos recuperados ofrecen una base documental y enlaces. Se pueden volver a indexar los conocimientos actualizados sin volver a entrenar los pesos del modelo.
Para el coste de generación
Evitar pagar una API por cada respuesta
El modelo de respuesta se ejecuta en el dispositivo del visitante. Por tanto, en este recorrido no pago por tokens ni por solicitudes a una API de generación. El alojamiento, las descargas y el mantenimiento siguen teniendo un coste.
Para la gestión
Gestionar los ajustes desde el CMS
Se pueden configurar los modelos, el ámbito documental y los parámetros de búsqueda. Los perfiles independientes permiten probar una configuración para móviles y otra para ordenadores.
Privacidad: ningún diálogo se envía a una API de generación
El modelo procesa la pregunta, los fragmentos recuperados y el historial en el navegador. No envío el diálogo a una API de generación para obtener una respuesta. La memoria opcional de la conversación también permanece en el navegador y el visitante puede borrarla.
Sin embargo, el servidor del sitio interviene en la búsqueda: recibe los vectores que representan las preguntas y devuelve los fragmentos. En esta primera versión, las preguntas sin respuesta y su mensaje alternativo se registran en el CMS para ampliar los conocimientos. Los archivos de los modelos se descargan desde servicios remotos. Por tanto, la ventaja es generar localmente y tener más control sobre estos flujos, con intercambios con el servidor claramente identificados.
El presupuesto se concentra en el alojamiento, las descargas, la integración, el mantenimiento de los contenidos y las pruebas. Por tanto, el interés económico depende del volumen de conversaciones y del coste de la primera carga. Aún no he medido ningún aumento de las conversiones. La primera versión demuestra que funciona; aún queda por evaluar su efecto en el uso.
Debilidades que conviene conocer antes de generalizar
Una primera descarga considerable
El modelo de respuesta elegido ocupa alrededor de 2 GB de archivos, a los que se suman unos 279 MB de E5 Base para los embeddings. La caché del navegador puede evitar descargarlos en cada visita, pero su conservación depende del dispositivo, del espacio disponible y de las políticas del navegador.
Este tamaño corresponde a los archivos descargados; la memoria necesaria para ejecutarlos es otra cuestión. En una conexión móvil limitada, un dispositivo poco potente o un navegador que vacíe la caché, el primer acceso puede ser un obstáculo importante.
La compatibilidad debe probarse en dispositivos reales
Las pruebas documentadas incluyen Samsung Internet en un Samsung S25 Ultra y Chrome en un ordenador con GPU NVIDIA. No validan todos los teléfonos ni todos los navegadores. La presencia de WebGPU no basta: también importan los controladores, la memoria y el motor de inferencia.
Firefox, Opera y los demás entornos deben evaluarse por separado. Cuando un dispositivo no puede ejecutar el modelo, el recorrido debe explicar la situación y facilitar el acceso a los contenidos y al contacto. El sistema actual no cambia silenciosamente a una generación en servidor.
Respuestas que pueden ser lentas o incorrectas
El procesamiento local y la revisión llevan tiempo. Las respuestas largas o las preguntas de seguimiento pueden superar el minuto en un móvil. Un dispositivo que se caliente, se quede sin memoria o ahorre batería también puede comportarse de otra manera.
El RAG reduce la falta de contexto, pero no elimina los errores del modelo. La revisión utiliza el mismo modelo: es un control adicional, no una verificación independiente de la veracidad. Una respuesta plausible puede seguir siendo incorrecta; las fuentes y los límites del ámbito siguen siendo esenciales.
Datos que hay que mantener y flujos que hay que explicar
Un documento obsoleto o la ausencia de información no se vuelven fiables porque una IA los reformule. Hay que mantener los conocimientos y el índice, y los datos que cambian rápidamente requieren una conexión a una fuente actualizada.
La generación local mantiene el procesamiento del modelo en el dispositivo. La búsqueda transmite al servidor vectores que representan las preguntas. En esta versión, las preguntas sin respuesta y su mensaje alternativo se registran en el CMS para ampliar los conocimientos. Los modelos se descargan desde servicios remotos. Hay que explicar estos flujos al visitante.
36 segundos en mi teléfono de prueba: una referencia, no una promesa
Mi objetivo es ofrecer respuestas útiles en menos de un minuto en móviles para las consultas habituales. En las pruebas del 27 de septiembre sobre el precio de un sitio web informativo se obtuvieron los siguientes resultados, con los modelos ya en caché y la revisión incluida.
Dispositivo probado
Recorrido medido
Tiempo
Samsung S25 Ultra · Samsung Internet
Respuesta completa y revisada sobre el precio de un sitio web informativo
36,11 s
Ordenador · Chrome · GPU NVIDIA Ampere
Respuesta completa y revisada sobre el mismo tema
13,06 s
Las respuestas generadas no tienen exactamente la misma extensión. Estas dos mediciones describen mis dispositivos y mi protocolo; no son una clasificación de navegadores ni una velocidad garantizada para cada pregunta. La descarga inicial no está incluida. En el móvil de prueba, algunas consultas más complejas superaron el minuto.
También he comparado los embeddings E5 Base y E5 Small. Un modelo más pequeño acelera algunas etapas, pero esa mejora no basta para demostrar que la respuesta final sea mejor. Hay que medir tanto la latencia como la pertinencia respecto al conjunto de conocimientos. Por eso, sigue abierta la búsqueda de modelos más ligeros.
Un asistente administrable, con aspectos que aún deben evaluarse
El resultado visible se apoya en un trabajo menos visible: índice documental, búsqueda vectorial, gestión de las descargas y la caché, workers para la inferencia, memoria local, reformulación, control de las respuestas y adaptación al teclado móvil.
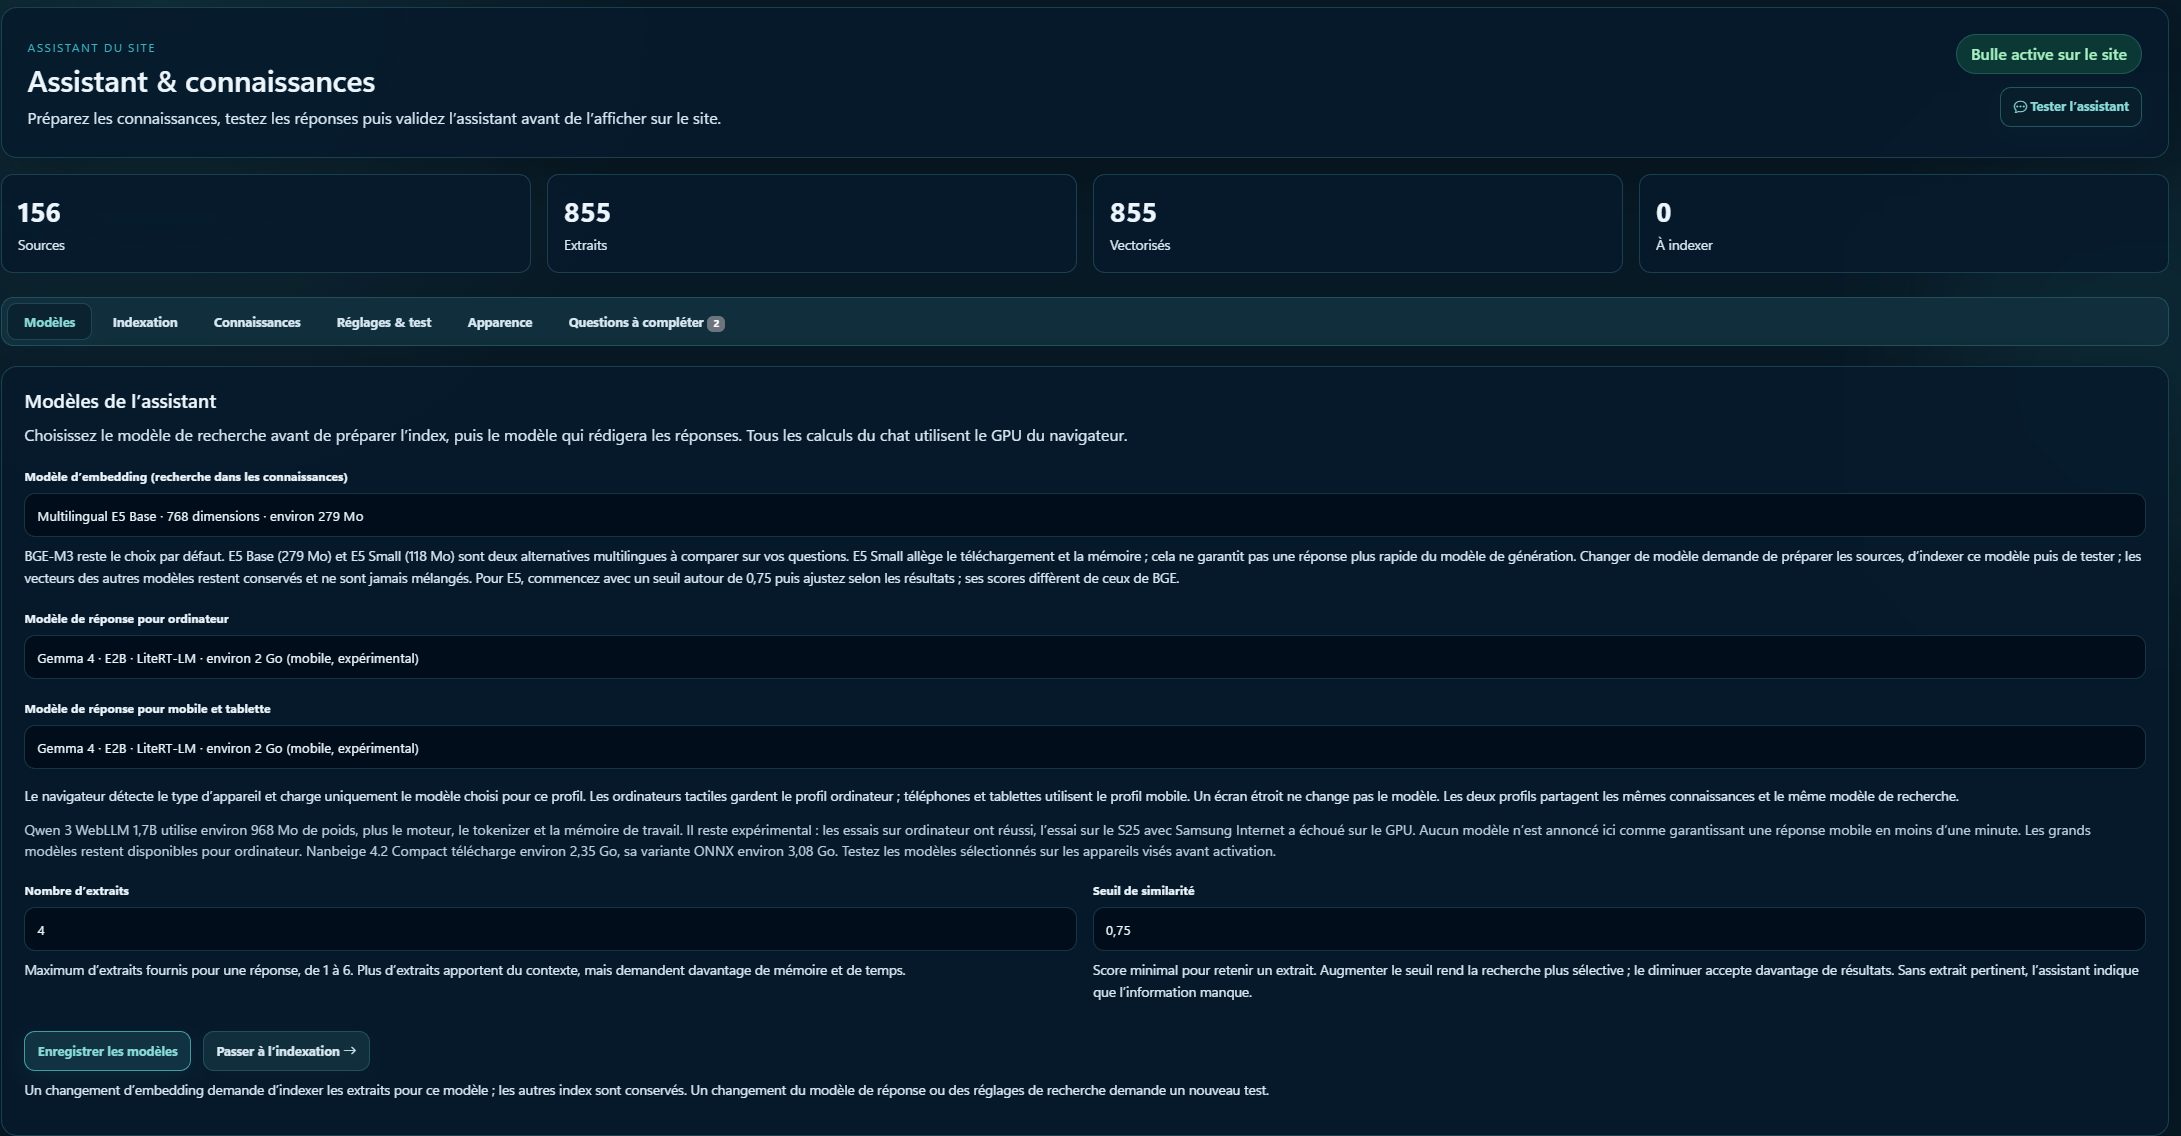
El CMS mantiene modelos de respuesta separados para móviles y ordenadores. El navegador detecta el tipo de dispositivo y carga el perfil correspondiente. En la fecha de publicación, Gemma 4 E2B con LiteRT-LM está seleccionado para ambos perfiles, y E5 Base para los embeddings. Los perfiles son independientes para permitir otras opciones tras las pruebas.
Un cambio importante en la configuración exige una nueva prueba y una nueva activación. Así se evita confundir «disponible en una lista» con «validado en el recorrido real».
Ajustes reales del CMS «Asistente y conocimientos». Las opciones técnicas se gestionan sin modificar el código del widget.
Los próximos pasos están claros: ampliar las pruebas en GPU y navegadores móviles, medir la primera carga, comparar los modelos con un conjunto de preguntas profesionales y estudiar opciones de exportación más ligeras. Se podría valorar la generación alternativa en servidor para algunos dispositivos, con una decisión explícita sobre los costes y los datos. No forma parte de esta primera versión.
¿Se adapta a tu proyecto? Cinco preguntas antes de empezar
El mejor punto de partida es una necesidad concreta y comprobable, no un asistente que supuestamente lo haga todo.
¿Qué preguntas hay que resolver? Encontrar un servicio, comparar algunos productos o afinar la búsqueda de una vivienda: elige un ámbito concreto.
¿Qué datos son fiables? Identifica los documentos, quién es responsable de ellos y qué información requiere una API o un catálogo actualizado.
¿Qué dispositivos utilizan tus visitantes? Prueba los navegadores reales, la conexión, la primera descarga y la memoria disponible.
¿Cómo se reconoce un resultado aceptable? Mide el tiempo, la exactitud, las fuentes y la capacidad de decir «no lo sé», e incluye también preguntas difíciles.
¿Cómo se puede retomar el control? Mantén los enlaces a las páginas, los filtros habituales y una forma sencilla de contactar con una persona.
Con esta primera versión he desarrollado un asistente especializado que utiliza los conocimientos de mi sitio y aprovecha la capacidad de procesamiento del navegador. También demuestra por qué el modelo por sí solo no basta: los datos, los controles y la interfaz determinan la utilidad del resultado.
Fuentes y método Experiencia de SDX — 27 de septiembre de 2026
Este artículo describe la primera versión publicada en SDX Development. Las capturas proceden del proyecto real; la imagen de portada es una ilustración. Los casos inmobiliarios, comerciales, turísticos y de formación son posibles líneas de adaptación; no se atribuyen resultados de clientes ni resultados comerciales.
Los tiempos proceden de las pruebas documentadas del 27 de septiembre de 2026 en un Samsung S25 Ultra y en un ordenador con Windows y GPU NVIDIA Ampere. Incluyen el proceso de respuesta y revisión, con los modelos en caché, pero no su descarga inicial. El protocolo, los límites y las opciones de modelos se detallan en el caso práctico.