RAG et WebGPU : quand votre site devient un assistant IA
J’ai développé un assistant qui recherche dans les connaissances de mon site et génère ses réponses dans le navigateur. Retour sur cette première version : bénéfices, limites et applications possibles.
Votre site contient déjà les réponses. Encore faut-il que vos visiteurs les trouvent. Et s’ils pouvaient simplement expliquer ce qu’ils cherchent ?
« Combien coûte un site vitrine ? », « Que comprend la maintenance ? », « Est-ce adapté à mon projet ? » : ces questions traversent plusieurs pages, rubriques ou FAQ. Développeur freelance, j’ai conçu et mis en ligne une première version d’un assistant IA RAG qui s’appuie sur les contenus de SDX Development et génère ses réponses dans le navigateur, grâce à WebGPU.
Le résultat ouvre des perspectives au-delà de mon propre site : aider à trouver un logement, choisir un produit technique, découvrir une formation ou consulter une documentation. Mais cette approche a aussi des limites concrètes. Voici ce qu’elle permet aujourd’hui, ce qu’elle demande à l’appareil du visiteur et les applications qu’il reste à construire.
RAG et WebGPU : les connaissances du site, le calcul du navigateur
Le RAG, pour Retrieval-Augmented Generation, consiste à rechercher des informations pertinentes avant de demander au modèle de rédiger une réponse. Au lieu de compter uniquement sur ce que l’IA a appris pendant son entraînement, on lui fournit des extraits de documents sélectionnés pour la question posée.
WebGPU permet à une application web d’utiliser le processeur graphique de l’appareil pour des calculs. Dans ce système, il sert à exécuter le modèle de réponse et le modèle d’embeddings : ce dernier transforme une question en un vecteur numérique pour rechercher des contenus proches par leur sens.
Préparer les connaissances. Le CMS découpe les documents en passages, calcule leur représentation et construit l’index avant les conversations.
Comprendre la question. Le navigateur utilise le contexte récent, peut reformuler une demande de suivi et calcule le vecteur de recherche.
Retrouver les passages utiles. Le serveur interroge l’index et renvoie des extraits autorisés pour le site et la langue concernés.
Rédiger et relire. Le modèle local prépare une réponse, puis effectue une étape de contrôle avant son affichage. Si les informations manquent, l’assistant doit le signaler.
Afficher la réponse et ses sources. Le visiteur peut consulter les pages utilisées et poursuivre sa demande.
Le navigateur et le serveur ont donc chacun un rôle. Les fichiers des modèles doivent être téléchargés, et la recherche documentaire reste connectée au serveur. Ce n’est pas un assistant entièrement hors ligne. La description détaillée des composants, des contrôles et des échanges de données est disponible dans mon étude de cas technique de l’assistant IA RAG.
Ce que fait déjà la version SDX
Sur mon site, l’assistant aide à consulter les prestations, les tarifs et les informations pratiques. Les connaissances se pilotent dans le CMS : documents, indexation, modèles, comportement de l’assistant et validation avant activation.
La mémoire locale est facultative. Elle conserve jusqu’à 60 échanges pendant 7 jours dans le navigateur utilisé, avec une commande pour l’effacer. Elle permet de reprendre une discussion et de comprendre une question comme « Et la maintenance ? » après avoir parlé d’un site vitrine.
Cette mémoire ne réentraîne pas le modèle. Une ancienne réponse ne remplace pas les documents actuels comme source factuelle. La reformulation sert à retrouver le sujet de la demande, puis la recherche consulte à nouveau les connaissances.
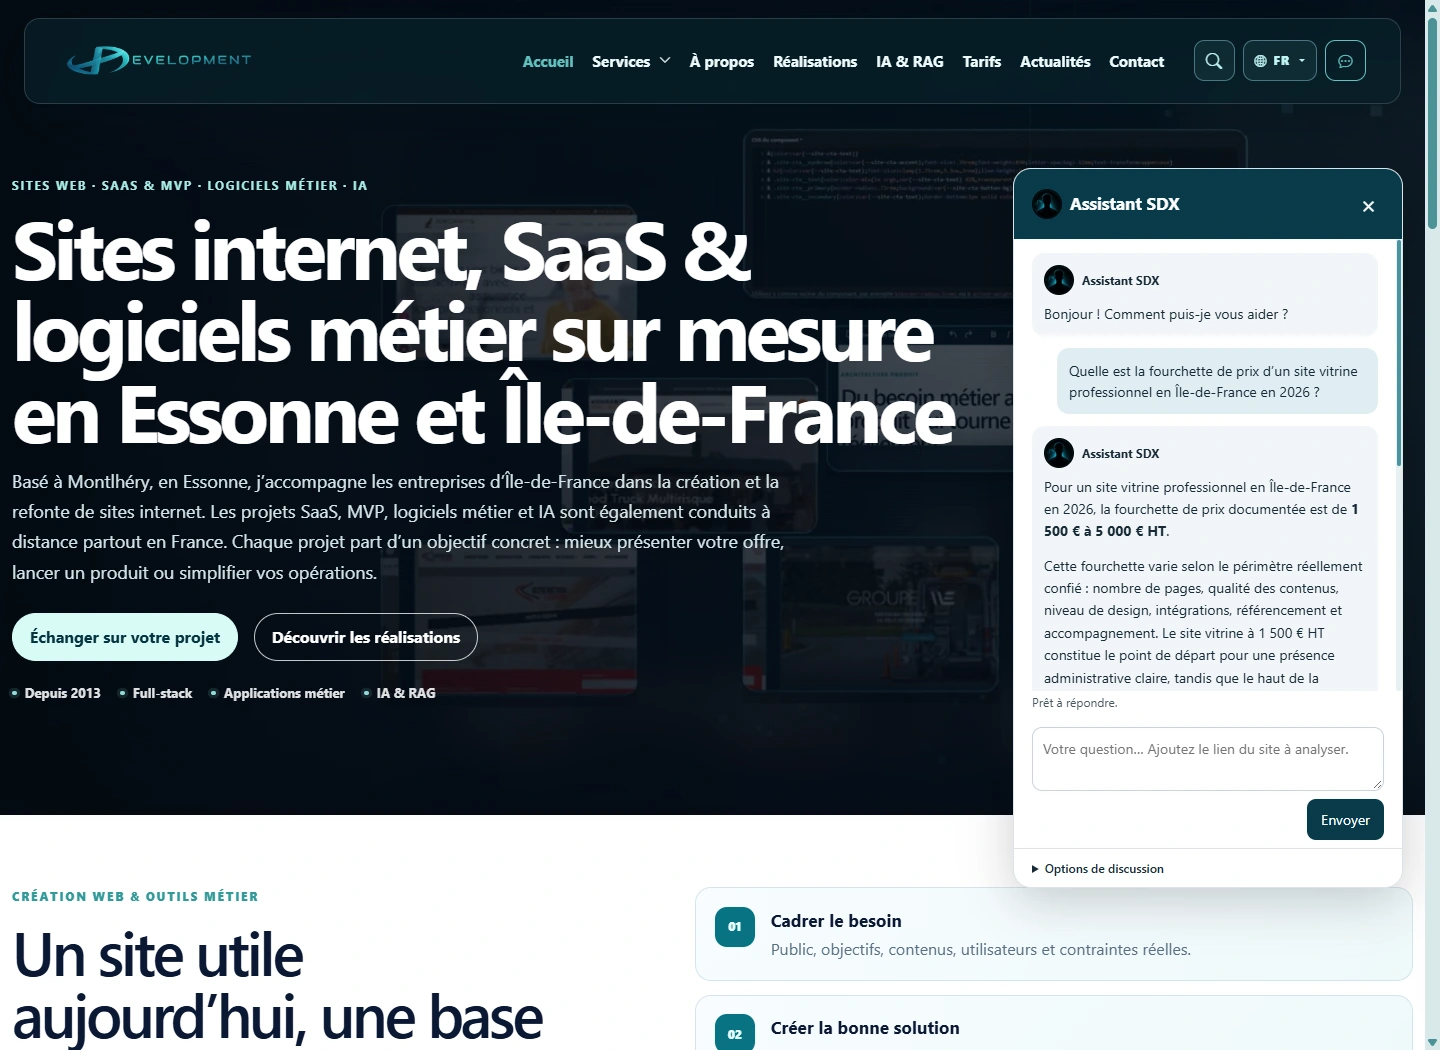
Capture réelle d’un de mes essais pendant le développement. Elle illustre l’interface et les sources ; le modèle de réponse a évolué depuis cette capture.
J’ai aussi adapté l’interface sur Android : fenêtre occupant la hauteur visible, zone de saisie plus compacte, bouton d’envoi accessible avec le clavier ouvert et lanceur masqué pendant la discussion. L’écran peut rester allumé durant le chat lorsque le navigateur autorise cette fonction.
Lorsque le parcours le prévoit, l’assistant peut préparer le remplissage d’un formulaire avec les informations explicitement fournies. Le visiteur garde la main : aucun consentement n’est coché et aucun formulaire n’est envoyé automatiquement.
Immobilier : passer des critères à une sélection expliquée
L’immobilier est une application particulièrement intéressante. Un visiteur ne pense pas toujours en filtres : il explique un projet de vie, des contraintes et des préférences.
« Je cherche un trois-pièces avec un balcon, près des transports, pour moins de 300 000 €. Je travaille souvent de chez moi. Quels biens pourraient me convenir ? »
Un assistant pourrait demander la zone recherchée, distinguer les critères indispensables des souhaits, puis proposer une sélection argumentée : pourquoi ce logement correspond, quel compromis il impose et où consulter l’annonce originale. Une relance comme « Plutôt au calme, et avec un bureau » viendrait préciser la recherche.
Le langage naturel doit s’appuyer sur un catalogue fiable
Le prix, la surface, le nombre de pièces et la disponibilité doivent être filtrés dans les données structurées de l’agence. La recherche sémantique peut ensuite aider à rapprocher les descriptions des préférences exprimées. Demander seulement à un modèle de « trouver un logement » dans des textes ferait courir le risque d’une recommandation hors budget ou d’un bien déjà vendu.
Une intégration sérieuse relierait donc l’assistant au catalogue à jour, aux règles de recherche et aux fiches des biens. Les temps de trajet, les équipements du quartier ou les disponibilités de visite nécessiteraient leurs propres sources fiables. L’IA ne doit pas les inventer.
L’intérêt serait de rendre une recherche plus compréhensible : présenter quelques biens et expliquer les correspondances plutôt que laisser le visiteur parcourir seul une longue liste. Une demande de visite pourrait ensuite être préparée, puis confirmée et envoyée par le visiteur.
Quatre autres applications à explorer
Les scénarios suivants sont des possibilités d’adaptation, pas des déploiements clients déjà réalisés. Ils ont un point commun : une question précise et des informations vérifiables pour y répondre.
01
Un catalogue de produits techniques
Aider à comparer des équipements selon un besoin et leurs caractéristiques documentées. La compatibilité, les prix et les stocks resteraient contrôlés par les données du catalogue, avec un relais humain pour les choix sensibles.
02
Un site de tourisme ou d’hébergement
Orienter vers un séjour, un logement ou une activité selon les préférences. Les disponibilités et les tarifs viendraient du système de réservation ; le RAG servirait à expliquer les services et les conditions.
03
Un organisme de formation
Rapprocher un objectif professionnel des programmes, des prérequis et des publics visés. L’assistant pourrait expliquer les différences et préparer une demande de conseil, sans garantir une admission ou un financement.
04
Une documentation de logiciel métier
Retrouver une procédure, clarifier une fonctionnalité ou guider un utilisateur dans une étape. Des documents privés exigeraient une authentification et des autorisations de recherche adaptées : ma démonstration actuelle utilise des connaissances publiques.
Les avantages : une autre porte d’entrée dans vos contenus
Pour le visiteur
Exprimer son besoin avec ses mots
Le dialogue peut relier plusieurs pages et tenir compte des précisions successives. Le visiteur n’a pas besoin de connaître le vocabulaire du site ou l’emplacement exact d’une information.
Pour les connaissances
Répondre avec des références consultables
Les passages retrouvés apportent une base documentaire et des liens. Une mise à jour des connaissances peut être réindexée sans réentraîner les poids du modèle.
Pour le coût de génération
Éviter une facture d’API à chaque réponse
Le modèle de réponse s’exécute sur l’appareil du visiteur. Je n’ai donc pas de facturation au token ou à la requête auprès d’une API de génération pour ce parcours. L’hébergement, les téléchargements et la maintenance restent à financer.
Pour l’exploitation
Garder des réglages dans le CMS
Les modèles, le périmètre documentaire et les paramètres de recherche sont configurables. Des profils séparés permettent de qualifier un choix pour mobile et un autre pour ordinateur.
Confidentialité : aucun dialogue envoyé à une API de génération
La question, les passages retrouvés et l’historique sont traités par le modèle dans le navigateur. Je n’envoie pas le dialogue à une API de génération pour obtenir une réponse. La mémoire facultative de la conversation reste aussi dans le navigateur, où le visiteur peut l’effacer.
Le serveur du site intervient toutefois dans la recherche : il reçoit les vecteurs représentant les questions et renvoie les extraits. Dans cette première version, les questions sans réponse et leur message de repli sont enregistrés dans le CMS pour compléter les connaissances. Les fichiers des modèles sont téléchargés depuis des services distants. L’avantage est donc une génération locale et davantage de contrôle sur ces flux, avec des échanges serveur clairement identifiés.
Le budget se concentre sur l’hébergement, les téléchargements, l’intégration, l’entretien des contenus et les tests. L’intérêt économique dépend donc du volume de conversations et du coût du premier chargement. Je n’ai pas encore mesuré de gain de conversion. La première version prouve un fonctionnement ; son effet sur les usages doit encore être évalué.
Les faiblesses à connaître avant de généraliser
Un premier chargement conséquent
Le modèle de réponse retenu représente environ 2 Go de fichiers, auxquels s’ajoutent environ 279 Mo pour les embeddings E5 Base. Le cache du navigateur peut éviter de les télécharger à chaque visite, mais sa conservation dépend de l’appareil, de l’espace disponible et des politiques du navigateur.
Cette taille concerne les fichiers téléchargés : la mémoire nécessaire à l’exécution est un autre sujet. Sur une connexion mobile limitée, un appareil peu puissant ou un navigateur qui évince le cache, le premier accès peut être un obstacle majeur.
Une compatibilité qui se teste sur de vrais appareils
Les essais documentés portent notamment sur Samsung Internet avec un Samsung S25 Ultra et Chrome sur un ordinateur équipé d’un GPU NVIDIA. Ils ne valident pas tous les téléphones ni tous les navigateurs. La présence de WebGPU ne suffit pas : les pilotes, la mémoire et le moteur d’inférence comptent aussi.
Firefox, Opera et les autres environnements demandent leur propre qualification. Lorsqu’un appareil ne peut pas exécuter le modèle, le parcours doit expliquer la situation et laisser un accès simple aux contenus et au contact. Le système actuel ne bascule pas silencieusement vers une génération sur un serveur.
Des réponses qui peuvent être lentes ou incorrectes
Le calcul local et la relecture prennent du temps. Les réponses longues ou les reprises peuvent dépasser une minute sur mobile. Un appareil qui chauffe, manque de mémoire ou économise sa batterie peut également se comporter différemment.
Le RAG réduit le manque de contexte, mais ne supprime pas les erreurs du modèle. La relecture utilise le même modèle : c’est un contrôle supplémentaire, pas une vérification indépendante de la vérité. Une réponse plausible peut rester fausse ; les sources et les limites du périmètre restent essentielles.
Des données à maintenir, et des échanges à expliquer
Un document obsolète ou une information absente ne devient pas fiable parce qu’une IA la reformule. Les connaissances et l’index doivent être entretenus, et les données qui changent vite demandent une connexion à leur source à jour.
La génération locale garde le calcul du modèle sur l’appareil. La recherche transmet au serveur des vecteurs représentant les questions. Dans cette version, les questions sans réponse et leur message de repli sont enregistrés dans le CMS pour compléter les connaissances. Les modèles sont téléchargés depuis des services distants. Ces flux doivent être expliqués au visiteur.
36 secondes sur mon téléphone de test : un repère, pas une promesse
Je vise des réponses utiles en moins d’une minute sur mobile pour les demandes courantes. Sur la question du prix d’un site vitrine, les essais du 27 septembre ont donné les résultats suivants, modèles déjà présents en cache et relecture incluse.
Appareil testé
Parcours mesuré
Temps
Samsung S25 Ultra · Samsung Internet
Réponse complète et relue sur le prix d’un site vitrine
36,11 s
Ordinateur · Chrome · GPU NVIDIA Ampere
Réponse complète et relue sur le même sujet
13,06 s
Les réponses produites n’ont pas exactement la même longueur. Ces deux mesures décrivent mes appareils et mon protocole ; elles ne constituent pas un classement des navigateurs ni une vitesse garantie pour chaque question. Le téléchargement initial est exclu. Des demandes plus complexes ont dépassé une minute sur le mobile de test.
J’ai aussi comparé les embeddings E5 Base et E5 Small. Un modèle plus petit accélère certaines étapes, mais ce gain ne suffit pas à prouver une meilleure réponse finale. Il faut mesurer à la fois la latence et la pertinence sur l’ensemble des connaissances. La veille sur des modèles plus légers reste donc ouverte.
Un assistant administrable, avec des choix qui restent à qualifier
Le résultat visible repose sur un travail moins visible : index documentaire, recherche vectorielle, gestion des téléchargements et du cache, workers pour l’inférence, mémoire locale, reformulation, contrôle des réponses et adaptation au clavier mobile.
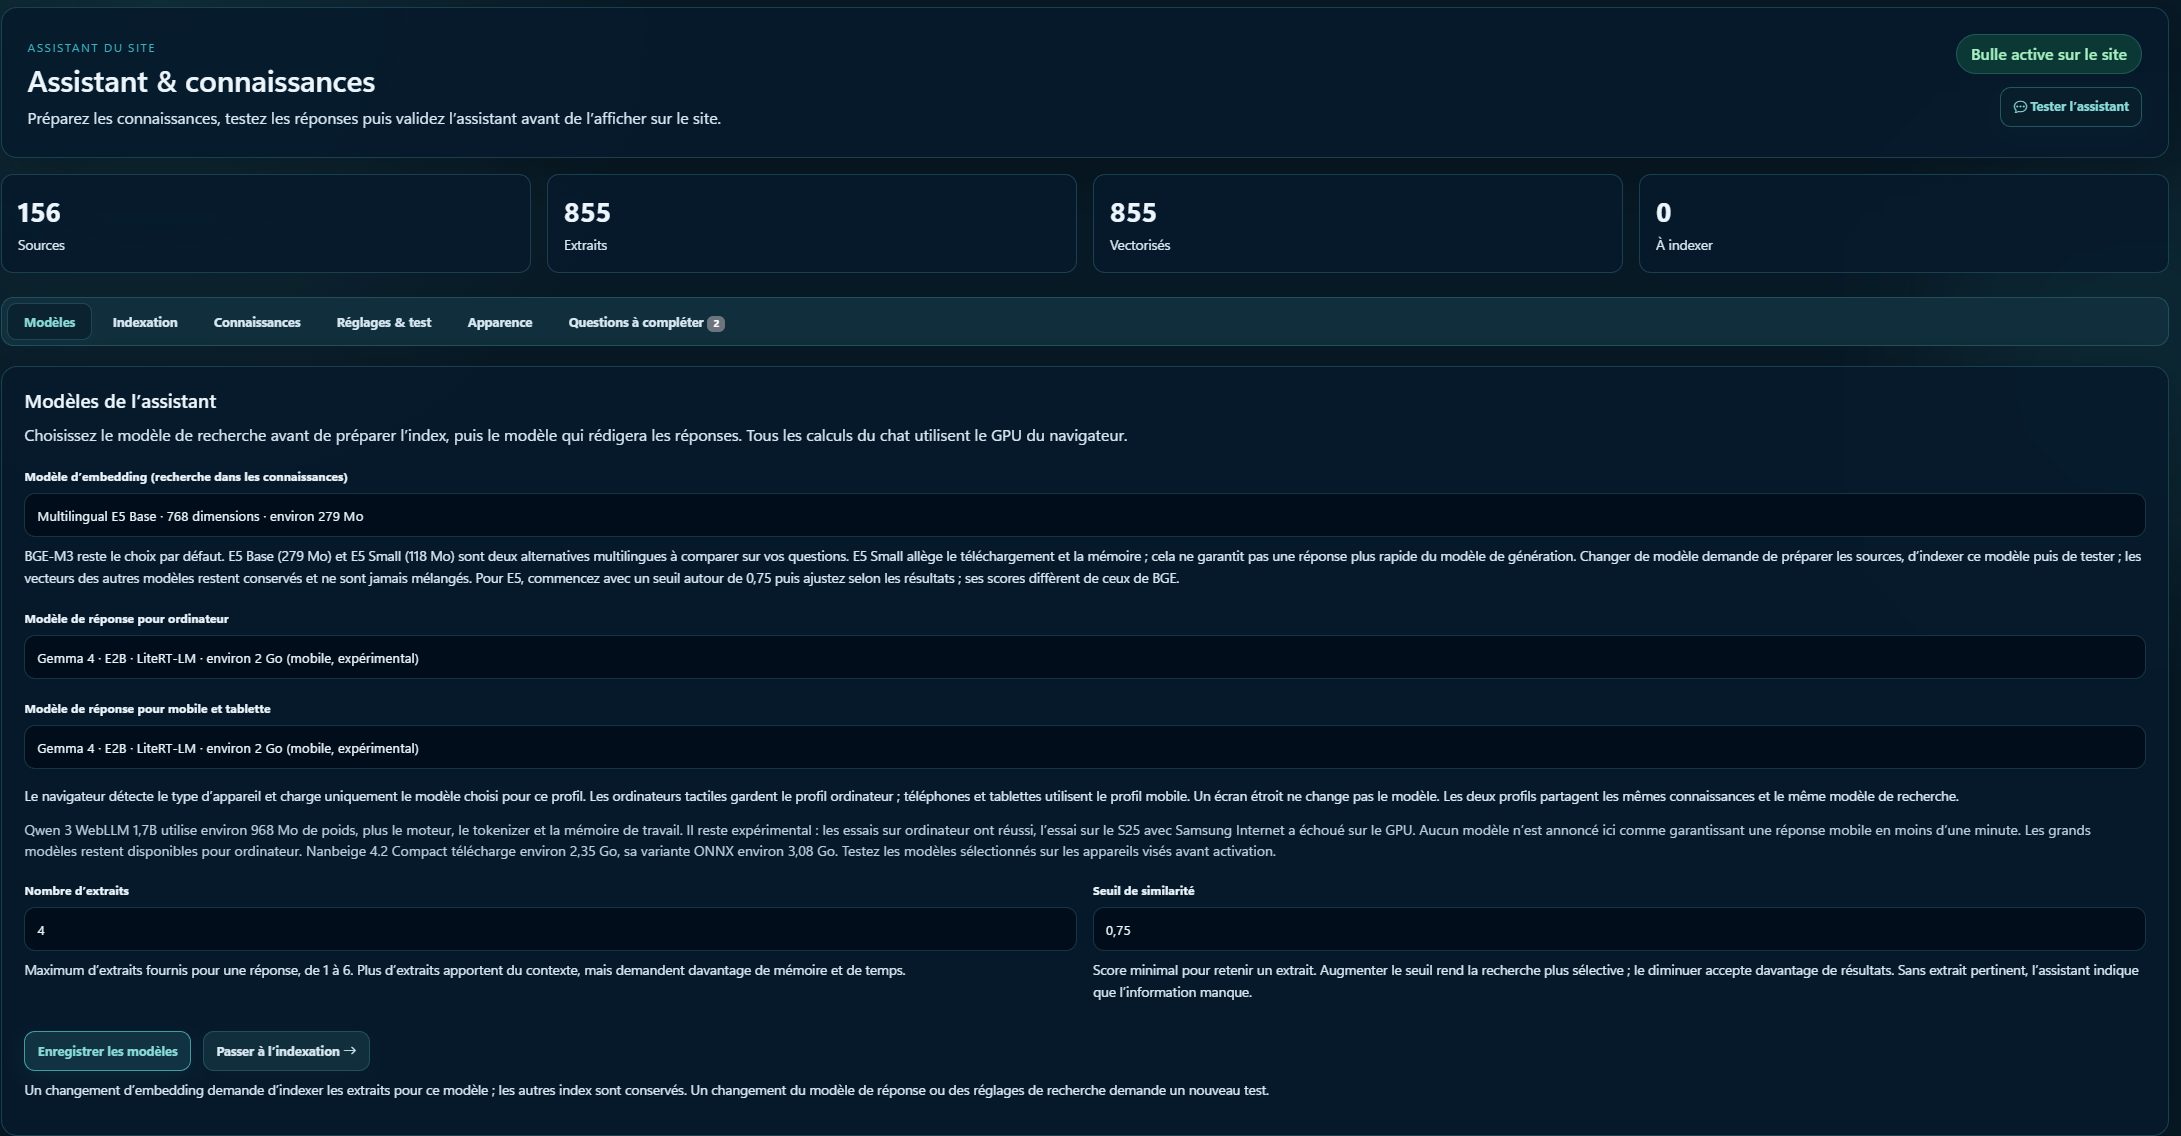
Le CMS sépare les modèles de réponse pour mobile et ordinateur. Le navigateur détecte le type d’appareil et charge le profil correspondant. À la date de publication, Gemma 4 E2B avec LiteRT-LM est sélectionné pour les deux profils, et E5 Base pour les embeddings. Les profils restent indépendants pour permettre d’autres choix après essais.
Une modification importante de la configuration exige un nouveau test et une réactivation. Cette étape évite de confondre « disponible dans une liste » avec « validé dans le parcours réel ».
Réglages réels du CMS « Assistant et connaissances ». Les choix techniques se pilotent sans modifier le code du widget.
Les prochaines pistes sont claires : élargir les essais sur les GPU et navigateurs mobiles, mesurer le premier chargement, comparer les modèles sur un jeu de questions métier et étudier des exports plus légers. Un relais de génération sur serveur pourrait être envisagé pour certains appareils, avec un choix explicite sur les coûts et les données. Il ne fait pas partie de cette première version.
Est-ce adapté à votre projet ? Cinq questions avant de commencer
Le meilleur point de départ est un besoin limité et testable, plutôt qu’un assistant censé tout faire.
Quelles questions faut-il résoudre ? Retrouver une prestation, comparer quelques produits ou préciser une recherche de bien : choisissez un périmètre concret.
Quelles données font autorité ? Identifiez les documents, leur responsable et les informations qui exigent une API ou un catalogue à jour.
Quels appareils utilisent vos visiteurs ? Testez les navigateurs réels, la connexion, le premier téléchargement et la mémoire disponible.
Comment reconnaître un résultat acceptable ? Mesurez le temps, la justesse, les sources et la capacité à dire « je ne sais pas », avec des questions difficiles aussi.
Comment reprendre la main ? Gardez les liens vers les pages, les filtres classiques et un contact humain accessible.
Avec cette première version, j’ai développé un assistant spécialisé qui utilise les connaissances de mon site et fait travailler le navigateur. Elle montre aussi pourquoi le modèle seul ne suffit pas : les données, les contrôles et l’interface déterminent l’utilité du résultat.
Sources et méthode Retour d’expérience SDX — 27 septembre 2026
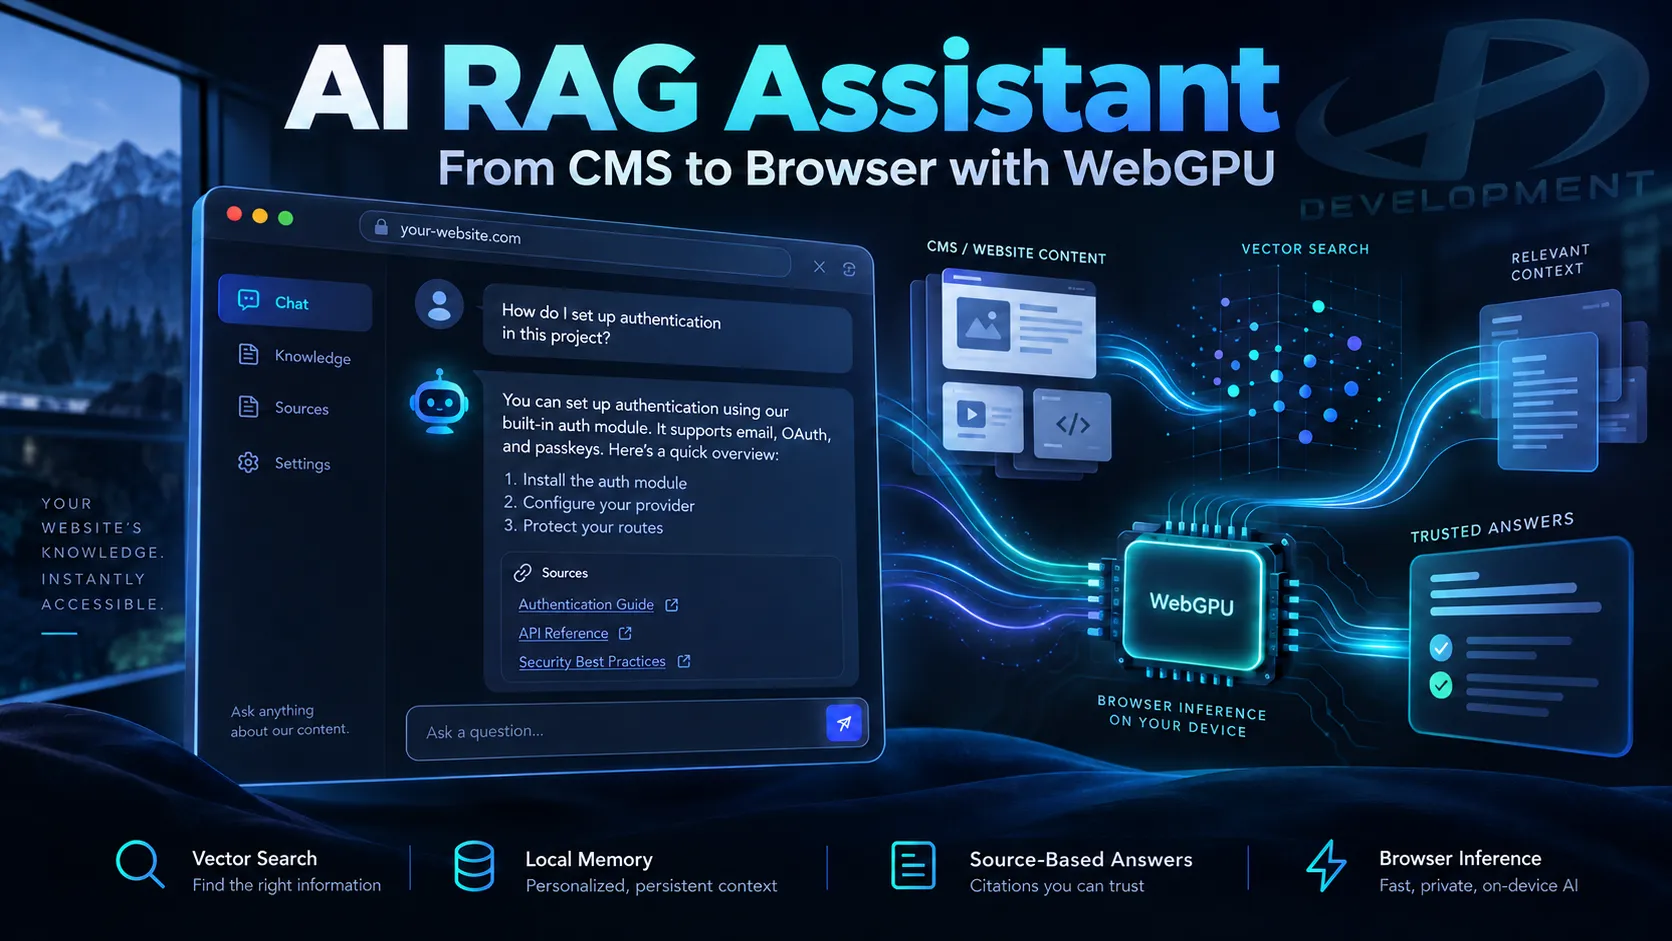
Cet article décrit la première version mise en ligne sur SDX Development. Les captures sont issues du projet réel ; la vignette de couverture est une illustration. Les cas immobiliers, commerciaux, touristiques et de formation sont des pistes d’adaptation, sans résultat client ni performance commerciale attribués.
Les temps proviennent des essais documentés du 27 septembre 2026 sur Samsung S25 Ultra et sur ordinateur Windows avec GPU NVIDIA Ampere. Ils incluent le parcours de réponse et de relecture, avec les modèles en cache, et excluent leur téléchargement initial. Le protocole, les limites et les choix de modèles sont détaillés dans l’étude de cas.